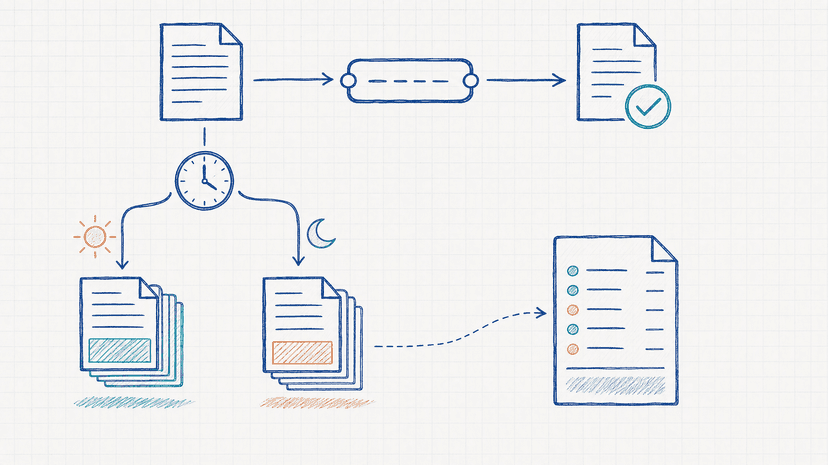
很多 Codex SDK 教程一上来就画工作流:队列、数据库、多个 Agent、自动发 PR。图看着很完整,真正照做时,最基础的三个问题却没说清楚:一次任务怎样开始,结果从哪里读,失败以后凭什么继续。
本篇聚焦服务端 TypeScript 包 @openai/codex-sdk,官方文档要求 Node.js 18 或以上。它可以新建、继续与恢复本地 Codex 线程;Python SDK 的独立入口请查看官方 SDK 页面。
先跑通一条最短链路
准备一个干净目录,确认 Node 版本,再安装包:
| node --version |
| npm install @openai/codex-sdk |
代码结构可以很小。创建客户端,启动一个线程,给它一项边界明确的任务,然后消费返回事件。具体 API 名称应以安装版本对应的官方示例为准,不要从旧文章复制后直接假设仍然兼容。
先确认本机 Codex 已正常认证。将下列官方调用方式保存为 example.mjs,再运行 node example.mjs;应得到线程最终回答。示例未在本文执行,失败时保留错误与当前依赖版本。
| import { Codex } from "@openai/codex-sdk"; |
| const codex = new Codex(); |
| const thread = codex.startThread(); |
| const result = await thread.run("只读取 README,说明项目启动方式,不修改文件。"); |
| console.log(result.finalResponse); |
官方 SDK 用法与恢复线程说明:https://learn.chatgpt.com/docs/codex-sdk
结果不是只有最后一句话
把 SDK 当成一个返回字符串的函数,很快会踩坑。任务运行过程中可能有状态变化、工具调用、增量内容和错误。程序如果只等最后一段文本,既看不到中途失败,也无法给日志、超时和重试一个可靠依据。
更稳的做法是把事件按三类处理:过程事件用于日志和进度;需要用户注意的事件进入界面或告警;最终结果才进入下游业务。任何事件都别把 API Key、Cookie 或完整敏感输入原样写进日志。
程序还要定义停止条件。超时是结束这一次等待,还是取消任务?连接断开以后恢复原线程,还是新开线程?没有这几个判断,所谓自动化只是把人工卡住换成后台卡住。
新建、继续、恢复,不是一回事
新建线程适合独立任务,历史最干净。继续线程保留同一件事的上下文,适合补充约束或让它根据刚才的结果修订。恢复线程解决的是进程退出后重新接管,而不是无限延长一段混乱对话。
工程里最好保存线程标识、业务任务标识和最后成功事件的位置。三者分开,才能判断重试是否会重复产生副作用。会写文件、发消息、创建 PR 的任务尤其要做幂等检查,不能因为网络重连就执行两遍。
认证和模型入口放在哪一层
SDK 负责把 Codex agent 纳入你的程序,不等于替你解决所有上游认证。Key 应由运行环境的 Secret 管理注入,不能硬编码在 TypeScript,也不能跟线程记录一起落库。
如果团队需要管理多个模型入口,可以使用第三方平台的 Key、渠道和调用记录;这不是 SDK 的必需依赖。Provider、认证方式和 Endpoint 应按服务方当前文档配置,不能把某个平台的地址当作所有 SDK 用户的通用设置。
从最小闭环再往外长
验收顺序很简单:一次线程能开始;过程事件能被记录;最终结果能区分成功和失败;重启程序后能恢复;重复执行不会制造第二份副作用。完成这五项,再接队列、数据库和多个 agent。
本文提供基于官方文档的入门步骤,示例未进行付费 API 调用验证。请在自己的环境确认安装、认证、线程结果与恢复行为;不据此声称实测性能或成功率。