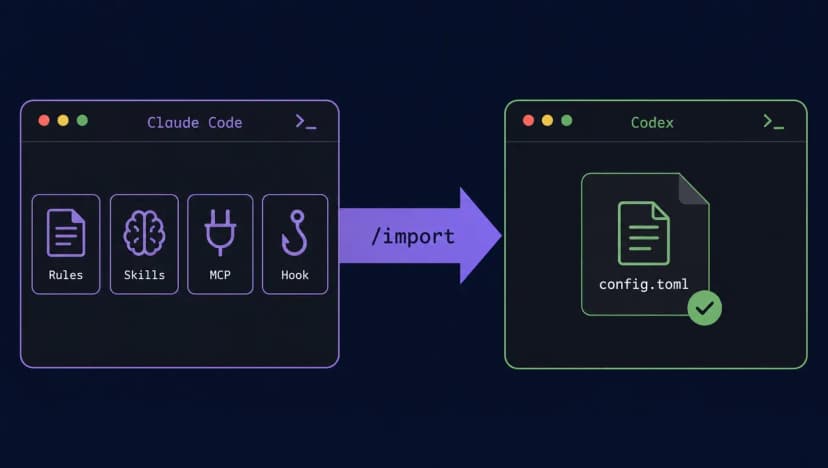
結論から:tstack は Theo(t3dotgg)が 10 月 26 日にオープンソース公開した 9 つの Agent スキルです。インストールはフォルダを ~/.claude/skills/ か ~/.codex/skills/ にコピーするだけ。私たちは本サイトの同じ API Key 1 つで Claude Code と Codex の両方をつなぎました。結果:
- インストール(リポジトリの clone と両クライアントへのコピー)は約 3 秒;
- Codex 0.164.0 で「sol loop」と言うだけで、gpt-6.1-sol のサブエージェントが起動してコードをレビュー。2 ラウンド・62 秒で、整数除算のバグを見つけて修正しました;
- Claude Code 2.1.310 はそのままでは sol-loop を実行できず、「Sol を実行できる手段がない」と正直に報告します。
model: gpt-6.1-solを指定したサブエージェントを追加すると、2 ラウンド・70 秒で完了; full-sendは Agent に自分で PR をマージさせます。両側でgh pr mergeを止めるルールを設定し、どちらもテストで実行を防げました。
API Key を作成して、1 つの Key で Claude Code と Codex をつなぐ →
tstack とは
Theo が X に投稿した告知ポストによると、tstack は「毎日使っているスキル」を整理して公開したものです。執筆時点でこのポストは約 44 万回表示され、GitHub リポジトリのスターは約 2,000、ライセンスは MIT です。README では Claude Code と Codex の両方で動くとしており、一部のスキルは T3 Code の機能があればそれを使い、なければクライアント標準のツールに切り替わります。
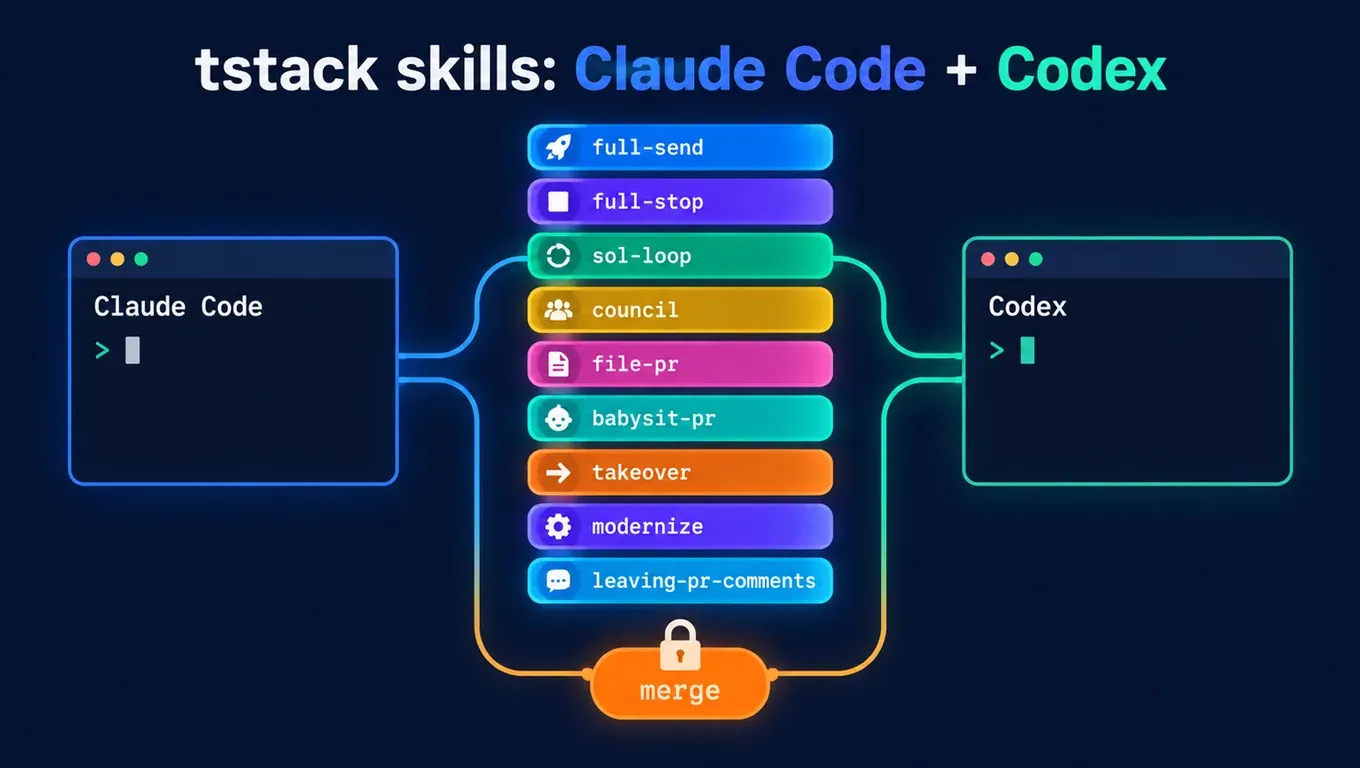
9 つのスキルとトリガー(リポジトリの README による):
| スキル | 言うこと | 内容 |
|---|---|---|
| full-send | full send | 無人で、変更を仕上げ、証明し、レビューし、PR を出し、CI を見届けたうえで自分でマージする |
| full-stop | full stop | full-send と同じだが「マージ可能」で止まり、マージはしない |
| council | council | 3 社の異なるプロバイダのモデルに、意見が一致するまでレビューさせる |
| sol-loop | sol loop | GPT Sol に変更をループでレビューさせ、双方が合意するまで続ける |
| file-pr | file a PR | 変更の羅列ではなく、問題から書き始める短い PR を出す |
| takeover | take over | 他人の PR、ブランチ、Agent のスレッドを引き継いで仕上げ、クレジットは残す |
| babysit-pr | babysit | PR が CI とレビューボットを通るまで見守り、本当の指摘を直す |
| modernize | modernize | 古い PR を rebase し、まだ存在すべきかを判断する |
| leaving-pr-comments | 自動 | Agent があなたの代わりに投稿するコメントの書式を決める |
スキル同士には依存関係があります:full-send は sol-loop、file-pr、babysit-pr を使い、full-stop は full-send を使います。全部入れるのがいちばん手軽です。
ステップ 1:Claude Code と Codex を設定する
両クライアントとも本サイトの同じ Key で大丈夫です。
Claude Code はグローバルの ~/.claude/settings.json に書きます:
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.aicodewith.ai",
    "ANTHROPIC_AUTH_TOKEN": "YOUR_API_KEY"
  },
  "model": "claude-sonnet-5-5"
}
アドレスは https://api.aicodewith.ai で、/v1 は付けません。詳しい手順は『Claude Code をサードパーティ API につなぐ方法』を参照してください。
Codex はグローバルの ~/.codex/config.toml に書きます:
model = "gpt-6.1-sol"
model_provider = "aicodewith"

[model_providers.aicodewith]
name = "aicodewith"
base_url = "https://api.aicodewith.ai/chatgpt/v1"
wire_api = "responses"
experimental_bearer_token = "YOUR_API_KEY"
各項目の意味は『Codex config.toml 設定ガイド』を参照してください。
ステップ 2:tstack をインストールする
git clone https://github.com/t3dotgg/tstack
mkdir -p ~/.claude/skills ~/.codex/skills
cp -R tstack/skills/* ~/.claude/skills/   # Claude Code
cp -R tstack/skills/* ~/.codex/skills/    # Codex
この手順は実測で約 3 秒でした。インストール後、Claude Code は起動時にスキルを表示し、Codex もトリガーを言うと対応する SKILL.md を読みにいきます。スキルとは何か、どこに置くかは『AI エージェントで Skills を使う方法』をご覧ください。
ほかに必要なもの:full-send や babysit-pr のように PR を出すスキルにはログイン済みの GitHub CLI(gh)が、babysit-pr の待機スクリプトには python3 が必要です。
ステップ 3:同じ Key で GPT Sol を呼び、sol-loop を動かす
まず Key で Sol を呼べるか確認します。本サイトのモデル一覧には gpt-6.1-sol があります。Responses エンドポイントに一文を送ると、約 4 秒で HTTP 200 が返りました:
curl https://api.aicodewith.ai/chatgpt/v1/responses \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"gpt-6.1-sol","input":"Reply with exactly: SOL_OK"}'
テスト用プロジェクトはごく小さなものです。calc.py の average() に空リストの判定を足しましたが、同じ変更で / を // にしてしまっています。既存のテストは整数の平均しか確かめていないので、テストは通ります。このバグを Sol に見つけてもらいます。
Codex の場合
プロジェクトのディレクトリで実行します:
codex exec --sandbox workspace-write "sol loop: review the current uncommitted changes (no remote, use HEAD as the base). After approval, do not commit or push."
62 秒で終わりました。セッションログを見ると、Codex はまず T3 Code の delegate_task を探し、見つからなかったので標準の spawn_agent でサブエージェントを起動し、パラメータに "model":"gpt-6.1-sol" を指定していました。流れは次のとおりです:
- ラウンド 1:Sol が、
average([1, 2])が1ではなく1.5を返すと指摘; - メイン Agent が
/に戻し、test_average_fractionalテストを追加して、そのテストが修正前のコードでは失敗することを確認; - ラウンド 2:Sol が承認。commit も push もしていません。
Codex の最終報告(原文からの翻訳):
sol-loop を 2 ラウンド完了。GPT-6.1 Sol が最終承認し、未解決の項目はありません。
- S1 を修正:整数除算で小数の平均が誤っていた。/ に戻し、空リストの処理は残し、回帰テストを追加。
commit も push もしていません。変更は作業ツリーに残っています。
Claude Code の場合
「sol loop」とだけ言うと、Claude Code は実行を断ります。11 秒で返ってきた内容(原文からの翻訳):
Sol のレビューは実行できなかったため、この変更はレビューを通過していません。
ブロッカー:ここには Sol を実行できる手段がありません……sol-loop のルールにより、別のモデルで代用せず、レビューがないことを承認とはみなしません。
これはスキル自体のルールです。Claude Code では、Sol を動かせるサブエージェントがある場合だけ実行し、別のモデルへの置き換えは禁止されています。対処法は ~/.claude/agents/sol-reviewer.md を新規作成することです:
---
name: sol-reviewer
description: Read-only code reviewer running GPT Sol. Use for the sol-loop skill.
model: gpt-6.1-sol
tools: Read, Grep, Glob, Bash
---
You are a read-only code reviewer. Never edit, commit, or push. Follow the review brief you are given and reply in its exact format.
本サイトの Anthropic 互換エンドポイントでも gpt-6.1-sol を呼べるので、このサブエージェントも同じ Key で動きます。もう一度実行:
claude -p "sol loop: review the current uncommitted changes (no remote, use HEAD as the base). After approval, do not commit or push." --permission-mode acceptEdits
実測 70 秒・2 ラウンドで、結果は Codex と同じでした。ラウンド 1 で Sol が VERDICT: CHANGES を返して除算の問題を指摘し、修正後のラウンド 2 で VERDICT: APPROVE になりました。出力の使用量統計には claude-sonnet-5-5(メイン Agent)と gpt-6.1-sol(レビュー用サブエージェント)の両方が載っており、レビューを実際に Sol が行ったことがわかります。
起動時に Claude Code は unrecognized_model という通知を 1 行出します。gpt-6.1-sol という名前を知らないためです。無視してかまいません。実行には影響しません。サブエージェントの設定は『Claude Code サブエージェントの設定』も参照してください。
| シナリオ | 結果 | 所要時間 |
|---|---|---|
| clone して両クライアントにコピー | 成功 | 約 3 秒 |
| Codex 0.164.0 で sol-loop | 2 ラウンド、Sol が承認 | 62 秒 |
| Claude Code 2.1.310、Sol サブエージェントなし | ブロッカーを報告、レビューなし | 11 秒 |
| Claude Code 2.1.310、sol-reviewer あり | 2 ラウンド、Sol が承認 | 70 秒 |
API Key を作成して、Claude Code と Codex で sol-loop を動かす →
full-send のリスク:Agent に自分でマージする権限を渡すこと
full-send の SKILL.md ははっきり書いています。「full send」と言った時点で、あなたはスレッドを見ていないとみなされ、Agent は変更をメインブランチへのマージまで進めます。Agent には明示的に 3 つの権限が与えられます:
- マージ条件を満たしたら、自分で PR をマージする;
- rebase 後、その PR 自身のブランチを
--force-with-leaseで強制 push する; - プロジェクトに「この種のテストは先に聞いて」とあっても、聞かずにテストを実行する。
制限もあります。--admin でブランチ保護を回避するのは禁止、データ削除や本番環境の操作は人に確認が必要です。ただしマージそのものはもう確認されません。マージで自動デプロイされるリポジトリなら、「full send」と言うことは Agent に勝手に本番リリースさせるのと同じです。
スキルには「ユーザーが full send と明確に言っていなければ完全自律と思い込まない」とありますが、これは Agent の判断に任されていて、確実なスイッチではありません。スキルを入れている限り、誤って発動する可能性があります。
無効にする・制限する方法
軽いものから順に:
方法 1:full-send を入れない
Sol にコードレビューだけさせたいなら、sol-loop フォルダだけをコピーし(ほかのスキルには依存しません)、full-send と full-stop はコピーしません。
方法 2:代わりに full-stop を使う
同じ流れをたどりますが「マージ可能」で止まり、マージはあなたがクリックします。
方法 3:Claude Code でマージコマンドを禁止する
グローバルの ~/.claude/settings.json に追加します:
{
  "permissions": {
    "deny": ["Bash(gh pr merge:*)", "Bash(gh api:*)"]
  }
}
gh api も禁止してください。でないと Agent が GitHub API を直接呼んでマージできます。Claude Code に gh pr merge 1 --squash を実行させたところ、5 秒以内にブロックされ、結果の permission_denials にこのコマンドが記録されました。
方法 4:Codex でマージコマンドを禁止する
ルールファイル ~/.codex/rules/default.rules を新規作成します:
prefix_rule(
    pattern = ["gh", "pr", "merge"],
    decision = "forbidden",
    justification = "Merging a PR must be done by a human",
)
テストでは 8 秒以内に拒否され、ログには rejected: Merging a PR must be done by a human と出ました。サンドボックスと承認の設定は『Codex サンドボックス権限の解説』もご覧ください。
方法 5:GitHub でブランチ保護を有効にする
マージ前に承認を必須にします。GitHub のドキュメントによると、PR の作成者は自分の PR を承認できません。Agent が使うのはあなたの gh アカウントなので、自分で承認をそろえることはできません。この層はクライアントの設定に左右されないので、いちばん確実です。
実際のリポジトリで full-send をマージまで走らせてはいません。テストしたのは、full-send が依存する sol-loop と、上の 2 つのブロック設定だけです。
よくある質問
T3 Code がなくても tstack は使えますか?
使えます。私たちは T3 Code を一度もインストールしていません。Codex は標準のサブエージェントを使い、Claude Code は上の手順で Sol サブエージェントを設定する必要があります。
sol-loop で別のモデルにレビューさせられますか?
スキルには「モデルを替えない」「Sol が使えなければブロッカーとして報告する」と明記されています。替えたい場合は SKILL.md を自分で編集してください。README も「自分用に書き換えて」と勧めています。
council には何が必要ですか?
README によると、council には 3 社の異なるプロバイダのフラッグシップモデルが同時にレビューする必要があります。例として Claude Opus、GPT Sol、Gemini Pro。本サイトの一覧には claude-opus-5-5、gpt-6.1-sol、gemini-4-argon があるので、sol-reviewer と同じ書き方でそれぞれサブエージェントを設定できます。この記事では council は試していません。
Codex の sol-loop は未コミットの変更しかレビューしませんか?
いいえ。remote があれば git merge-base でベースを見つけてブランチ全体をレビューし、remote がないときだけ HEAD を使います。作業ツリーの変更だけを見たいなら、Codex 標準のレビューも使えます。『Codex review で未コミットの変更をレビューする』をご覧ください。
テスト環境
- Claude Code 2.1.310、Codex CLI 0.164.0、Linux;
- tstack のコミット
92e38e2(2026-10-27); - メインモデル:Claude Code は
claude-sonnet-5-5、Codex はgpt-6.1-sol。レビュー用モデルはgpt-6.1-sol; - すべてのリクエストは本サイトの同じ API Key を使いました。テスト後、Key を含む設定とログは削除済みです。