分类、抽取、摘要和可验收的小型子 Agent 步骤,可以优先评估 Haiku 5.5;持续规划、困难调试和跨文件实现,Sonnet 5.5 更适合作为起始候选。两款模型可以分工,前提是你能检查小模型交回来的结果。
Haiku 的普通输入、输出单价在 prompt 不超过 100K 时是 Sonnet 的二十分之一;超过这条线后是四分之一。缓存、Token 用量和重试会继续改变差距,不能把单价比例直接写成一个编程任务节省多少。
资料核验于 2026 年 10 月 10 日。本文使用官方规格、供应商公布评测和可复算的假设账单,没有进行本站付费模型对测。对比对象是 Sonnet 5.5,旧版 Sonnet 5 的缓存价格和接口规则不能混入。
核心规格相近,任务定位不同
| 项目 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|
| Claude API 固定 ID | claude-haiku-5-5 | claude-sonnet-5-5 |
| 上下文窗口 | 1M Token | 1M Token |
| 普通同步最大输出 | 128K Token | 128K Token |
| 输入与输出 | 文本、图片 → 文本 | 文本、图片 → 文本 |
| 默认 API effort | medium | high |
| 官方定位 | 高并发、低延迟、分类与抽取 | 速度与能力平衡 |
两款模型都能接收较大上下文,但能装入相同数量的资料,不表示有相同的规划、检索或修复能力。普通同步上限与 Batch beta 的输出容量也需要分开,不能用 Batch 规格说明实时客户端。Haiku 规格、Sonnet 规格
编程能力:官方证据支持什么结论
Anthropic 的 Haiku 发布页列出 Terminal-Bench 4.0 的 Haiku 5.5 分数为 39.2%,Sonnet 5.5 为 70.6%。该测试关注在终端完成复杂、多步骤任务;发布页明确认为 Sonnet 和 Opus 仍更适合这类复杂 Agent 编程。官方发布与评测
这些是供应商在其评测设置中的结果,不能换算成你的仓库通过率,也不能推导出 Sonnet 在所有窄任务上都优于 Haiku。不同 effort、工具、运行方式和样本会影响成绩。本文不把该表当作本站同条件实测。
Haiku 的价值更容易在边界清楚的步骤里检验。例如从失败日志提取测试名称、查找某个符号的调用位置、把文档字段转换为固定结构。结果可以用原文、路径或校验器检查,发现错误后再交给主模型。
如果模型需要先定义“正确结果是什么”,例如诊断没有复现步骤的并发错误,或者决定几个服务的职责边界,直接从 Sonnet 开始更符合这一任务的判断需求。是否值得升级,最终看错误和人工返工的记录。
API 价格:100K 分界与缓存要一起算
下表为 Anthropic 标准直连 API,每百万 Token 美元价格,不含工具、区域和其他附加费用。
| 计费项 | Haiku,prompt ≤100K | Haiku,prompt >100K | Sonnet 5.5 |
|---|---|---|---|
| 普通输入 | $0.10 | $0.50 | $2.00 |
| 输出 | $0.50 | $2.50 | $10.00 |
| 缓存读取 | $0.01 | $0.05 | $0.10 |
| 5 分钟缓存创建 | $0.125 | $0.625 | $2.50 |
| 1 小时缓存创建 | $0.20 | $1.00 | $4.00 |
Haiku 的档位依据总 prompt 输入,包含缓存读取与写入。请求超过 100K 后,该次请求使用高档费率,不能只给超出的部分加价。Sonnet 5.5 的缓存读取已降到 $0.10,旧文章中的 $0.20 属于之前费率或其他型号。官方完整价格规则
下面三笔都是假设用量,目的是展示费用计算,不是实际调用账单:
| 单次请求 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|
| 50K 未缓存输入+5K 输出 | $0.0075 | $0.15 |
| 200K 未缓存输入+20K 输出 | $0.15 | $0.60 |
| 180K 缓存读取+20K 普通输入+5K 输出 | $0.0315 | $0.108 |
第一行的 Haiku 费用是 0.05×0.10 + 0.005×0.50 = $0.0075。第二行超过阈值,使用 0.2×0.50 + 0.02×2.50 = $0.15。
第三行总输入为 200K,Haiku 仍属于高档:0.18×0.05 + 0.02×0.50 + 0.005×2.50 = $0.0315。Sonnet 则为 0.18×0.10 + 0.02×2 + 0.005×10 = $0.108。这行只算当次缓存读取,不包含此前创建缓存的费用;费用差距也已不是普通单价的四倍。
实际模型可能用不同数量的 Token,thinking 按输出计费,工具结果又会增加下一次输入。比较时记录每次实际用量,别把固定 Token 算例当成固定任务成本。
重试和验收怎样改变选择
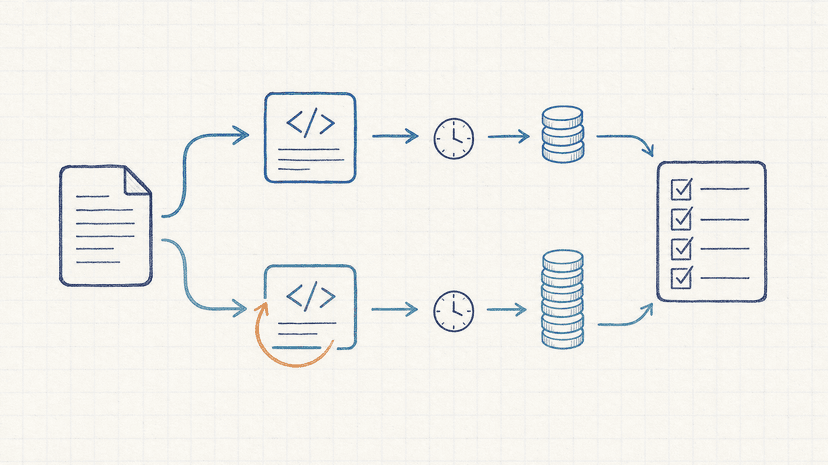
假设有 100 个彼此独立、可用固定规则验收的任务,每次使用第一行的 Token 预算。全部使用 Sonnet 且一次通过,费用为 $15。
另一条应用层路线是每个任务先运行一次 Haiku,其中假设 80 个通过,剩余 20 个再各运行一次独立 Sonnet 请求并通过。费用是 100×0.0075 + 20×0.15 = $3.75。
这里的 80% 通过率是算例假设,既不是官方分数,也不是本站实测。费用还没包含验收器、额外上下文、主 Agent 的协调和人工复核。如果验收器发现不了错误,或者升级请求要携带很长的失败历史,这条路线未必满足质量与成本要求。
所以,只有在验收可靠、任务范围稳定时,才适合尝试先小模型、失败后升级。复杂任务可以从 Sonnet 直接开始,再用真实失败记录判断分工是否值得。
API 兼容性:不要只替换 model
两款模型都默认使用 adaptive thinking,返回内容应按 type 解析,旧采样参数与 assistant prefill 也要检查。但它们并不共享所有请求规则:
- Haiku 5.5 接受强制工具选择,强制时会从工具调用开始,不带 thinking block。
- Sonnet 5.5 拒绝
tool_choice的any和指定工具模式,需要改用auto等支持的方式。 - Sonnet 5.5 关闭前置思考使用
between_tools,不是旧版的disabled,且有 effort 与字段限制。 - Thinking blocks 的跨模型、跨账户重放受限制。Haiku 不读取 Sonnet 5.5 的 thinking blocks,不能假设两款模型间切换会完整继承推理。
因此,一段在 Haiku 正常工作的工具调用代码,换成 Sonnet 也可能报错。核对 Haiku 迁移指南与 Sonnet 迁移指南,分别建立请求配置;格式约束还要检查目标平台支持。
如何完成一次有用的对照
先固定仓库提交、任务、文件范围、工具权限和验收方法。至少分别安排日志抽取、可复现的小 bug 和跨文件实现,保留失败样本。两款模型从独立新会话开始,避免第一轮结果影响第二轮。
Claude Code 中可用完整 ID 启动:
claude --model claude-haiku-5-5
claude --model claude-sonnet-5-5
使用 v2.1.293 或更新版本可满足这两款模型的官方版本要求。固定并记录 effort;默认体验与相同 effort 的对照分开做,分别记耗时、用量、缓存、重试和人工修正。Claude Code 型号选择
使用支持多个模型的 API 中转服务时,例如 AICodeWith,还需要固定渠道,核对实际模型和结算价格;上面的美元表不是中转服务报价。
结论
保留在你这类任务上通过验收、总费用和耗时可接受的路线。窄任务可以先试 Haiku,复杂持续工作从 Sonnet 开始;两者之间的分工应由可检查的结果决定。
常见问题
Haiku 5.5 的任务成本一定是 Sonnet 的二十分之一吗?
二十分之一对应 prompt 不超过 100K 时的普通输入和输出单价比例。超过阈值后这一比例变为四分之一;缓存、实际用量、重试和验收还会改变任务费用。
两款模型可以只替换 model 就上线吗?
还要核对 thinking、强制工具选择、响应块解析和历史会话规则。先在独立新会话完成目标任务,再验证工具流程与计费用量。
相关资料
需要进一步核算渠道、缓存和长输入时,可用 Haiku 5.5 API 费用指南。如果 Sonnet 在复杂任务上仍反复失败,再参考 Sonnet 5.5 与 Opus 5.5 对比安排更强模型的评估。