OpenAI hat am 23. Oktober Codex CLI 0.164.0veröffentlicht. Laut @thsottiaux am 24. Oktober imPostmacht ein Wechsel der Reasoning-Stufe mitten in Codex den Cache nicht mehr ungültig. In einemFolgepostfasst er dieses CLI-Update zusammen: Prompt-Presets, Inline-Einstellungen für Modell und Berechtigungen, MCP-Login für Unternehmen, Fix für fehlschlagende Wiederaufnahme langer Sitzungen und Proxy-Authentifizierung unter Windows im Firmennetz. Außerdem erwähnt er, dass sich die CLI-Nutzung seit der DevDay verdoppelt hat.
Das Wichtigste vorab:
- Neu ist
/presetsbietet zehn nummerierte Slots für häufig genutzte Prompts oder Slash-Befehle; im geöffneten Menü führt die Zifferntaste den Eintrag direkt aus. /modelunterstützt Inline-Parameter,/model gpt-6.1-sol --reasoning=highwechselt Modell und Reasoning-Stufe in einer Zeile;/permissionsakzeptiert ebenfalls Parameter.- Wir haben mit dem API-Key dieser Seite und einem benutzerdefinierten Provider getestet: Wird die Reasoning-Stufe mitten in der Sitzung von medium auf high und dann auf low gewechselt, gibt es bei der jeweils nächsten Anfrage weiterhin Cache-Treffer; nach
codex resume --lastbleibt die in der Sitzung geänderte Reasoning-Stufe erhalten, ohne vom globalen Standardwert überschrieben zu werden. - Unter Windows können sich HTTPS- und WebSocket-Verbindungen mit den Negotiate- oder NTLM-Anmeldedaten des aktuell angemeldeten Benutzers am Firmenproxy authentifizieren.
Übersicht der Änderungen in 0.164.0
| Änderung | Originaltext aus dem Release | Für wen relevant |
|---|---|---|
| Presets mit /presets | Save reusable prompts and slash commands in ten numbered /presets slots, with a keyboard menu for quick access. | Wer immer wieder denselben Prompt oder Befehl nutzt |
| /model und /permissions inline | Set model, reasoning effort, speed, and permission profiles directly with inline /model and /permissions arguments. | Wer häufig Reasoning-Stufe oder Berechtigungen wechselt |
| Credentials in Remote-Bash maskieren | Mask credentials during supported remote Bash commands and Zsh snapshot sessions, including credentials from custom providers. | Wer Codex in Remote-Umgebungen oder mit benutzerdefiniertem Provider nutzt |
| Einstellungen bei resume wiederherstellen | Resuming sessions now finds compressed histories and restores saved thread settings instead of replacing them with global defaults. | Wer häufig mit resume weiterarbeitet |
| Windows-Firmenproxy | Windows HTTPS and WebSocket connections now handle proxy authentication challenges using the signed-in user’s Negotiate or NTLM credentials. | Windows-Nutzer, die im Firmennetz über einen authentifizierenden Proxy gehen |
Weitere Änderungen: Bei Terminals mit Kitty- oder Sixel-Unterstützung lassen sich Bilder in der Vollbild-Aufzeichnung vorab ansehen; Enterprise-MCP-Verbindungen unterstützen die Autorisierung über das Codex-Konto oder einen separaten Login; der Einrichtungsassistent für Amazon Bedrock ist standardmäßig aktiviert; eine fehlgeschlagene Komprimierung hinterlässt keine halbe Zusammenfassung mehr im Verlauf; wenn-c oder --config bei mehrstufigen Unterbefehlen auftreten, gehen Overrides nicht mehr verloren.
Version und Voraussetzungen
Prüfen Sie zuerst die Version:
codex --version
# 低于 0.164.0 就升级
npm i -g @openai/codex@latest
Falls Codex noch nicht installiert ist, sieheCodex-Installationsanleitung. Für unseren Test haben wir einen benutzerdefinierten Provider aus der globalen ~/.codex/config.toml verwendet. Die Schreibweise ist dieselbe wie in derCodex-config.toml-Konfigurationsanleitung:
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
model_provider = "aicodewith"

[model_providers.aicodewith]
name = "aicodewith"
base_url = "https://api.aicodewith.ai/chatgpt/v1"
wire_api = "responses"
experimental_bearer_token = "你的 API Key"
Die Schritte für Netzwerk und Key in China finden Sie unterCodex in China nutzen.
/presets: 10 Slots für Prompt-Presets
So speichern Sie
Geben Sie in Codex /presetsein. Beim ersten Öffnen erscheint No presets saved. Press n to create one.. Die Tasten am unteren Menürand sind:
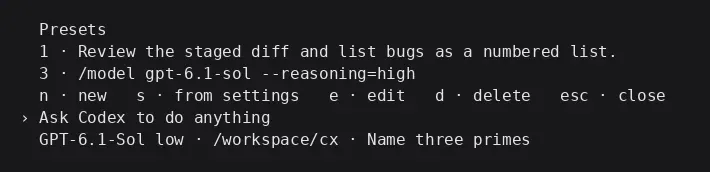
n · new s · from settings e · edit d · delete esc · close
- Mit
nlegen Sie ein neues Preset an: Prompt oder Slash-Befehl eingeben, mit Enter bestätigen und einen Slot wählen. Die Slots sind 1 bis 9 und 0, insgesamt also 10. Nach dem Speichern zeigt die Meldung eine Nummer wieSaved preset 1.. - Mit
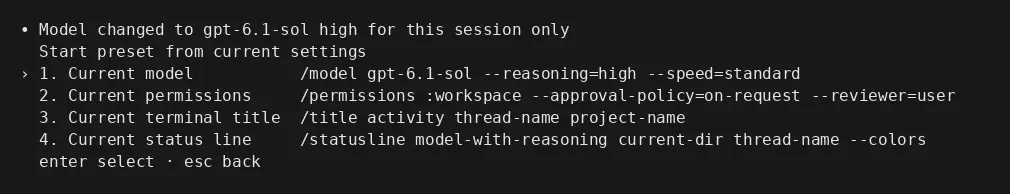
serzeugen Sie ein Preset aus den aktuellen Einstellungen: Es listet die vollständigen Befehle für aktuelles Modell, Berechtigungen, Terminaltitel und Statusleiste auf, und ein Eintrag genügt, um ihn als Preset zu speichern.
codex-0-164-presets-from-settings-terminal
Die Liste zeigt nebenbei die vollständige Schreibweise der Inline-Parameter, etwa für die aktuellen Berechtigungen: /permissions :workspace --approval-policy=on-request --reviewer=user.
In unserem Test liegen die Presets in ~/.codex/config.toml , pro Slot ein Abschnitt:
[tui.presets.1]
input = "Review the staged diff and list bugs as a numbered list."
label = ""
Sie können diese Datei also auch direkt bearbeiten, um Presets gesammelt zu pflegen.
So rufen Sie Presets auf
Geben Sie /presets ein, um das Menü zu öffnen. Die Zifferntaste des Slots führt das Preset direkt aus, ohne zusätzliche Bestätigung mit Enter.
codex-0-164-presets-terminal
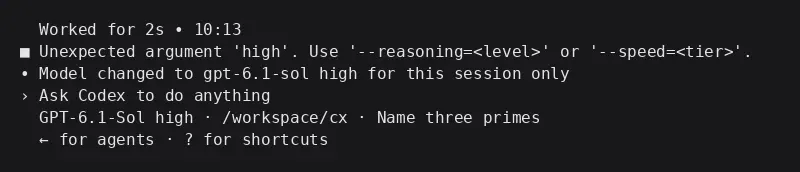
Ist im Preset ein Slash-Befehl gespeichert, verhält sich die Ausführung wie bei manueller Eingabe. Achten Sie auf die Schreibweise der Parameter: Wir hatten zunächst /model gpt-6.1-sol highgespeichert; beim Ausführen meldete der Client einen Fehler:
Unexpected argument 'high'. Use '--reasoning=<level>' or '--speed=<tier>'.
Nach der Umstellung auf /model gpt-6.1-sol --reasoning=high funktionierte der Wechsel.
/model: Reasoning-Stufe in einer Zeile wechseln
Verwendung
/model gpt-6.1-sol --reasoning=high
/model --reasoning=low
Sie können auch nur --reasoning ohne Modellnamen angeben; dann bleibt das aktuelle Modell erhalten und nur die Reasoning-Stufe ändert sich. Nach dem Wechsel erscheint:
Model changed to gpt-6.1-sol high for this session only
Hinweis zu for this session only: Der Inline-Wechsel gilt nur für die aktuelle Sitzung und ändert nicht den Standardwert in config.toml. Die untere Statusleiste zeigt die neue Reasoning-Stufe ebenfalls an.
codex-0-164-model-inline-terminal
Sie können auch Tastenkürzel nutzen: In der Kürzeltabelle, die Sie mit ? öffnen, stehtalt+, für Less reasoning,alt+. für More reasoning.
Greift der Cache nach dem Wechsel noch?
Wir haben in derselben Sitzung mehrere kurze Fragen nacheinander gesendet, dabei zweimal die Reasoning-Stufe gewechselt und aus dem Sitzungsprotokoll pro Runde cached_input_tokensausgelesen:
| Runde | Reasoning-Stufe | Input-Tokens | Cache-Treffer-Tokens |
|---|---|---|---|
| 1 | medium | 15996 | 1642 |
| 2 | medium | 16037 | 12120 |
| 3 | Wechsel auf high | 16074 | 10041 |
| 4 | Wechsel auf low | 16135 | 6232 |
| 5 | low nach resume | 16162 | 12218 |
Runde 1 ist ein Kaltstart, wenige Treffer sind normal. Runde 3 und 4 sind jeweils die erste Runde direkt nach dem Wechsel der Reasoning-Stufe und haben weiterhin Cache-Treffer, ohne auf Kaltstart-Niveau zurückzufallen. Das passt zu @thsottiaux’ Aussage, dass ein Wechsel der Reasoning-Stufe den Cache nicht mehr ungültig macht. Die Trefferzahl schwankt pro Runde; maßgeblich sind die Zahlen in Ihrer eigenen Sitzung.
Eine Runde dauerte jeweils 2 bis 11 Sekunden.
resume stellt Sitzungseinstellungen wieder her
Original aus den Release Notes: Resuming sessions now finds compressed histories and restores saved thread settings instead of replacing them with global defaults.
Testschritte: Der globale Standard ist medium. Wechseln Sie in der Sitzung mit /model --reasoning=low auf low, beenden Sie die Sitzung und führen Sie dann aus:
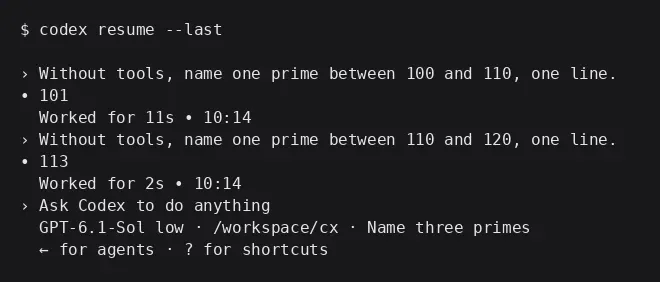
codex resume --last
Nach der Wiederherstellung zeigt die Statusleiste GPT-6.1-Sol lowan. Senden Sie eine weitere Runde: Im Sitzungsprotokoll steht für diese Runde weiterhin low, der globale Wert medium hat sie nicht überschrieben, und der Cache greift wie gewohnt (siehe Runde 5 in der Tabelle oben).
codex-0-164-resume-terminal
Credentials bei Remote-Bash maskieren
Original aus den Release Notes: Mask credentials during supported remote Bash commands and Zsh snapshot sessions, including credentials from custom providers.
Wenn Sie mit experimental_bearer_token einen eigenen Provider konfigurieren, bedeutet das: In unterstützten Remote-Bash-Befehlen und Zsh-Snapshot-Sitzungen fallen auch die Credentials des Providers unter die Maskierung. Legen Sie den Key trotzdem nur in der config.toml ab, nicht in Projektdateien, und fügen Sie ihn nicht in den Chat ein.
Windows-Unternehmensproxy mit Negotiate/NTLM
Ab 0.164.0 antwortet Codex unter Windows bei HTTPS- und WebSocket-Verbindungen auf eine Proxy-Authentifizierungsabfrage mit den Negotiate- oder NTLM-Credentials des aktuell angemeldeten Windows-Benutzers. Wenn Sie Codex unter Windows nutzen, lohnt sich zusätzlich ein Blick in dieCodex VS Code Windows-Anleitung.
Was bei Drittanbieter-APIs zu beachten ist
- Alle Tests in diesem Artikel liefen mit dem Key dieser Seite und einem eigenen Provider in der globalen config.toml, Modell
gpt-6.1-sol,/presets,/modelals Inline-Parameter sowie resume funktionieren einwandfrei. - Der eigene Provider schreibt den Key mit
experimental_bearer_tokenfest, zusätzliche Umgebungsvariablen sind nicht nötig. - Das Inline-
/modeländert nur die aktuelle Sitzung. Wollen Sie den Standard für die Reasoning-Stufe dauerhaft ändern, passen Sie weiterhin in der config.toml den Wertmodel_reasoning_effortan. - Gängige Alltagsabläufe finden Sie unterCodex verwenden.
Häufige Fragen
Wie aktualisiere ich Codex CLI 0.164?
npm i -g @openai/codex@latest, danach mit codex --version prüfen, ob 0.164.0 oder höher installiert ist.
Wo werden die /presets gespeichert?
In der globalen ~/.codex/config.toml im Abschnitt [tui.presets.N] ; N ist die Slot-Nummer. Im Menü können Sie mit e bearbeiten, mitd löschen oder die Datei direkt ändern.
Wie führe ich /presets schnell aus?
Geben Sie /presets ein, um das Menü zu öffnen, und drücken Sie die Slot-Ziffer, um direkt zu starten.
Wie wechsle ich in Codex die Reasoning-Stufe?
/model --reasoning=high schalten Sie in einer Zeile um, oder verwenden Sie alt+,oderalt+. als Tastenkürzel. Die Schreibweise /model gpt-6.1-sol high erzeugt den Fehler Unexpected argument 'high'.
Macht ein Wechsel der Reasoning-Stufe mitten in der Sitzung den Cache ungültig?
In unserem Test mit einem Drittanbieter-Key gab es nach dem Wechsel auf high und auf low jeweils in der ersten Runde noch Cache-Treffer.
Sind die Modelleinstellungen nach resume noch da?
Ab 0.164.0 werden die in der Sitzung gespeicherten Einstellungen wiederhergestellt. In unserem Test blieb nach codex resume --last das in der Sitzung eingestellte low erhalten, es fiel nicht auf den globalen Standard zurück.
Braucht der Windows-Unternehmensproxy zusätzliche Konfiguration?
Laut Release Notes beantwortet Codex Proxy-Authentifizierungsabfragen automatisch mit den Negotiate- oder NTLM-Credentials des aktuell angemeldeten Benutzers. Neue Konfigurationsoptionen werden nicht erwähnt.