先说结论:用 Codex 清理死代码,最稳的做法是先让它只出报告、写清每一处的证据,人确认后再一处一个 PR 地删,删完跑测试。
我们用 AICodeWith 的 Key 在开源项目 jmespath.py 上实测了两段提示词:只出报告用了 133 秒,找到 8 处可以删的代码;直接清理用了 43 秒,删了 7 处,测试全部通过。每一处我们都手动核对过,没有误删。
OpenAI 工程师是怎么做的
OpenAI 官方博客《Maintaining software with the GPT-6 family》里,负责实验平台的工程师分享了他们用 Codex 做代码维护的经历:
| 做了什么 | 结果 |
|---|---|
| 5 个工程师兼职,用了两周左右 | 合并了 1400 多个 PR,删掉 80 多万行代码 |
| 清理一个服务里的无用代码 | 容器镜像从 3.31GB 降到 1.72GB,小了 48% |
| 清理测试里的无用代码 | 删掉了大约 400 个视觉快照 |
| 清理一个标成“永久”的功能开关 | 主服务 CPU 估计省了 0.42% |
最后那个例子值得单独说。有一个功能开关被映射到了所有其他功能上,导致大量额外的 CPU 开销。模型查出了这个问题,算了 CPU 成本,但因为这个开关在后台被标成“永久”、可能还有运维用途,它没有直接删,而是交给人来判断。人看过之后才删掉。
这正是清理死代码该有的分工:AI 负责找出来、给证据,人负责拍板。
他们还用同一段提示词对比了不同模型,官方测试里 GPT-6.1 Sol 找到的问题接近 GPT-6 Astra,而且更省。
3 段提示词(中文改写版)
原文提示词针对 OpenAI 内部的工具(Slack、Statsig 实验平台)。下面改成了通用版本,可以直接用。
提示词 ①:找出并删除死代码
帮我找出并清理这个仓库里的死代码。删之前先确认它确实没被用到:搜调用方、看 git 历史和 AGENTS.md 的规则。
每删一处都说明理由。删完运行 AGENTS.md 里的测试命令,测试必须全部通过。不要提交 git,改动留在工作区给我审。
原文还让模型去查 Slack 和 Statsig,确认代码是不是真的没人用了。如果你的 Codex 能连上团队的聊天记录或功能开关平台,可以把这句加回去。
提示词 ②:清理过期的实验和功能开关
找出项目 {A} 中与过期、取值固定的功能开关或已废弃实验相关的死代码,并删除。
核对开关平台上的实际配置,查看 git 历史和相关的 PR。
保持线上行为不变,保留运维保护措施和用作应急开关(kill switch)的开关。
忽略 SDK 的默认回退值和本地覆盖配置。
每处清理单独建一个小的草稿 PR,在说明里附上该开关的配置链接。
关键是两条:线上行为不能变,应急开关一律保留。每处清理一个小 PR,审起来轻松,出问题也好回滚。
提示词 ③:扫描整个仓库,只出报告
/goal 扫描整个仓库,找出所有可以安全删除、且不改变任何对外行为的死代码:没人调用的函数和类、只为旧版本保留的兼容代码、永远走不到的分支、没人引用的文件。
要查间接用法:通过导出、字符串拼出来的名字、反射、测试和脚本里的调用。公开 API 和兼容/应急用的兜底代码要保留,只列出来让人判断。
只输出一份 Markdown 报告,写到 cleanup-report.md:按文件分组,每条写清文件和行号、证据、建议(删除 / 保留待人工确认)、风险。
不要修改任何代码文件。
这段适合第一次接手一个老仓库时用:先看清楚有哪些可以删,再决定从哪里下手。原文的版本还会按 CPU 开销排序,优先处理最费资源的地方。
实测:在 jmespath.py 上跑提示词 ③ 和 ①
测试仓库是 jmespath.py,一个从 2013 年维护至今的 Python 开源库,代码里还留着一些早年兼容旧版 Python 的痕迹。测试用的是 Codex CLI 0.162.1,模型是 gpt-6.1-sol,通过 AICodeWith 的 Key 调用。
| 提示词 | 耗时 | 结果 | 人工核对 |
|---|---|---|---|
| ③ 只出报告 | 133 秒 | 110 行报告,8 处建议删除,其余全部标成“保留待人工确认” | 8 处都确实没被用到,没有误报 |
| ① 直接清理 | 43 秒 | 删了 4 个文件里的 7 处,测试 991 个通过、1 个跳过 | 7 处都确实没被用到,没有误删 |
报告里建议删除的 8 处包括:一个引用了早已不存在的类的测试辅助函数、没用的 import、只赋值从不读取的变量、测试文件里没人用的常量。我们逐个全仓库搜索确认过。
报告也很克制:公开 API、兼容旧版本的分支、错误兜底、命令行脚本、性能测试数据,都列成了“保留待人工确认”,没有一刀切。
提示词 ① 跑完后,Codex 给出的清理说明如下,每一处都附了是哪个 git 提交之后变成死代码的:
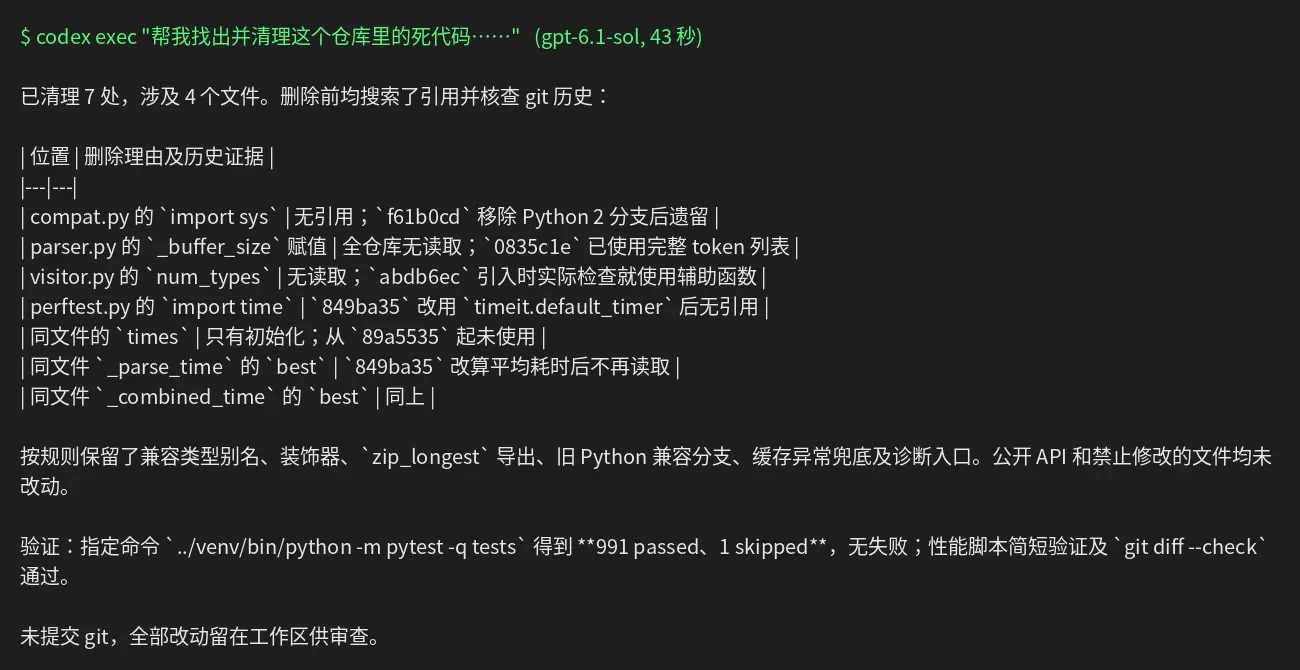
codex-dead-code-run
两次运行有两处判断不一样:compat.py里的import sys和parser.py里的_buffer_size,报告模式因为它们在兼容模块里或属于类的属性,标成了“待人工确认”,清理模式则直接删了。两处我们核对后确认仓库里都没有读取,测试也通过,但这正说明了先出报告、人来拍板的价值。
动手:第一步,创建 Key
第二步:全局配置 config.toml
编辑 ~/.codex/config.toml:
model_provider = "aicodewith"
model = "gpt-6.1-sol"

[model_providers.aicodewith]
name = "aicodewith"
base_url = "https://api.aicodewith.ai/chatgpt/v1"
wire_api = "responses"
experimental_bearer_token = "sk-你的Key"
Key 直接写在experimental_bearer_token里,不需要env_key,也不需要 auth.json。各字段说明见《Codex config.toml 配置指南》和《Codex 接入 AICodeWith》。
第三步:写 AGENTS.md,划出禁区
在项目根目录建 AGENTS.md,Codex 每次都会读。清理代码时最要紧的是写清楚哪些不能动:
# AGENTS.md
- 测试命令:pytest -q tests
- 不要改动:tests/compliance/、docs/、setup.py 里的版本信息
- 公开 API(包的 __init__.py 导出的名字)即使仓库里没人调用也要保留
- 用于兼容或应急的开关、兜底代码一律保留,只列出来让人判断
实测时 Codex 确实照着这几条做了:公开 API 和兼容代码都没碰,测试也是用这里写的命令跑的。
第四步:先报告,人确认,再一处一个 PR
- 用提示词 ③ 出报告,只读不改
- 自己过一遍报告,挑出确认能删的
- 用提示词 ① 或 ② 清理,每处一个小 PR
- 合并前跑完整测试
仓库很大时,可以让 Codex 把报告按目录拆开,交给多个子代理并行处理,做法见《Codex 子代理任务拆分》。
第五步:跑测试验证
删完一定要跑测试。我们的提示词里直接写了“删完运行测试,必须全部通过”,Codex 会自己跑。你在合并前再手动跑一遍:
pytest -q tests
让 Codex 修 bug 并跑测试的完整流程,见《Codex 修真实 bug 并跑测试》。
常见问题
用哪个模型清理死代码合适?
我们实测用的是 gpt-6.1-sol,一个中等规模的仓库两分钟左右出完报告。官方测试里 Sol 和 Astra 效果接近,Sol 更省。两者的详细对比见《GPT-6.1 Sol 和 Claude Opus 5.5 对比》。
Codex 会不会把还在用的代码删掉?
有可能,所以要按“先报告、人确认、再清理”的顺序来,并在 AGENTS.md 里写清禁区。官方博客里也提到,过去靠静态分析删代码时出过事故,像反射调用、留作应急的代码路径,都容易被误判成没用。
codex exec 跑起来一直没反应?
我们实测踩过这个坑:codex exec 会等待标准输入,在脚本里调用时如果没给输入,就会一直挂着。命令末尾加上 < /dev/null 就好了:
codex exec "你的提示词" < /dev/null
扫大仓库时报 429 怎么办?
请求太密集会触发限流,处理办法见《Codex 429 Too Many Requests》。