
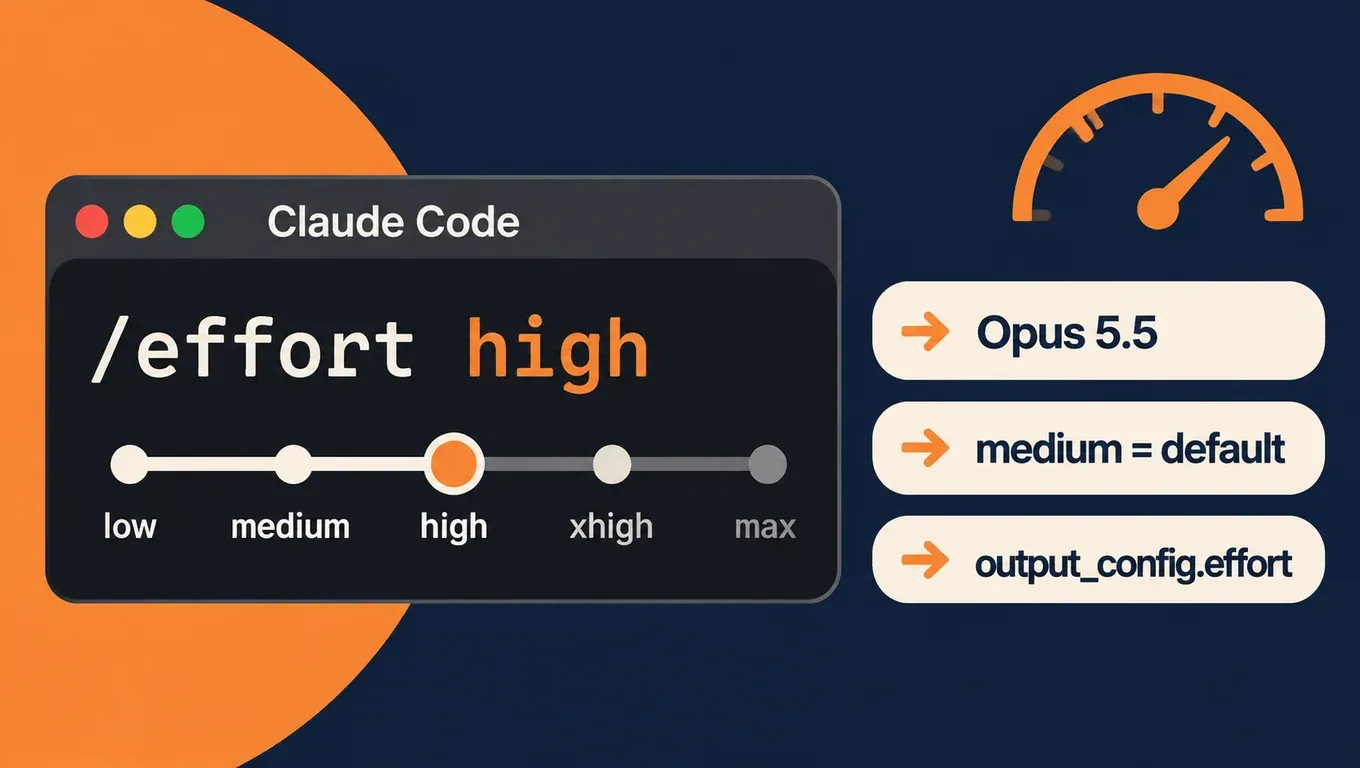
결론부터: effort는 Opus 5.5가 얼마나 오래 생각하고 스스로 얼마나 검증할지를 정하는 설정입니다. low, medium, high, xhigh, max 다섯 단계가 있고 기본값은 medium으로, Opus 5의 기본값 high보다 한 단계 낮습니다.
- 범위가 분명한 일상 개발(기능 구현 등)은 기본값
medium이면 충분합니다. 기존 코드베이스의 버그 수정이나 엣지 케이스가 많은 작업은high로, 모델이 스스로 여러 번 검증해야 하는 수십 분 이상의 긴 작업에는xhigh나max를 씁니다. Claude Code 공식 문서의 구분입니다. - 사용자 반응에 따르면 Opus 5.5를
xhigh에서high로 낮춘 많은 사람이 결과가 같거나 오히려 좋다고 말합니다. Artificial Analysis 측정에서 전체 평가를 돌리는 데xhigh는 출력 token 약 100M,high는 56M을 썼습니다. 약 1.8배의 token으로 5점이 높았습니다(57 대 52). - Claude Code의 함정:
~/.claude/settings.json최상위의 예전 방식"effortLevel": "high"는 Opus 5.5에 적용되지 않아 그대로medium으로 동작합니다. Opus 5.5를 선택한 상태에서/effort high를 한 번 실행하면 Claude Code가 모델별로modelSettings에 저장합니다. 저희 실측으로도 확인했습니다. - API에서는
"output_config": {"effort": "high"}를 보냅니다. 생략하면medium입니다.
API Key를 만들고 Claude Code, Codex, Cursor에서 Opus 5.5 쓰기 →
다섯 가지 effort 단계의 의미
effort는 엄격한 token 상한이 아니라, 이 작업에 얼마나 힘을 쓸지 모델에게 알려 주는 값입니다. 생각하는 길이뿐 아니라 답변 분량과 도구 호출 횟수에도 영향을 줍니다. 공식 문서에 따르면 낮은 단계에서도 충분히 어려운 문제라면 생각하지만 그 양이 줄어듭니다. Opus 5.5는 adaptive thinking이 항상 켜져 있고 끌 수 없으므로, 추론 깊이를 조절하는 핵심 설정이 effort입니다.
아래 표는 Anthropic의 권장 사항과 Artificial Analysis가 Intelligence Index v5를 단계별로 돌린 결과를 함께 정리한 것입니다(low / medium, high, xhigh / max 비교 페이지 참고):
| 단계 | Anthropic 권장 용도 | AA 점수 | 전체 평가 출력 token | 문제당 평균 시간 |
|---|---|---|---|---|
| low | 브레인스토밍, 초안, 이름 변경 같은 작은 수정, 서브에이전트 | 35 | 약 21M | 약 153초 |
| medium(기본값) | 범위가 분명한 일상 개발, 예를 들어 새 기능 구현 | 48 | 약 43M | 약 347초 |
| high | 검증이 중요하거나 엣지 케이스가 많은 작업, 예를 들어 기존 코드의 버그 수정 | 52 | 약 56M | 약 474초 |
| xhigh | 더 깊은 추론, 30분 이상의 긴 작업 | 57 | 약 100M | 약 793초 |
| max | 보안 취약점 찾기처럼 Claude에게 맡겨 두는 어려운 문제. 과하게 생각할 수 있음 | 58 | 약 218M | 약 1141초 |
high에서 xhigh로 가면 token이 약 1.8배로 늘고 5점이 오릅니다. xhigh에서 max로 가면 token이 두 배 넘게 늘고 1점이 오릅니다. AA는 medium, high, xhigh, max 네 단계가 모두 '지능 대 문제당 부담' 파레토 경계에 있다고 짚었습니다. 네 단계 모두 맞는 쓰임이 있고, 어느 하나가 무조건 최고는 아니라는 뜻입니다.
요즘 effort를 낮추는 이유
이 논의는 10월 31일에 시작됐습니다. Theo (t3.gg)의 게시물에 따르면 동료 Julius의 권유로 1~2주 전 Opus 5.5를 extra high에서 high로 바꿨는데 "거의 매번 더 낫다"고 합니다. 다음 날에는 effort 단계 순위 이미지를 올렸는데 high가 1위, medium과 xhigh가 그다음, max가 꼴찌였습니다.
다른 대표적인 반응:
- @zwb44에 따르면, AA 데이터를 그래프로 정리해 "xhigh는 1.8배 token으로 5점 상승"이라고 요약했고, 본인도
high를 주로 쓰자 사용량과 속도 차이가 확연했다고 합니다. - swyx에 따르면, 처리량이 중요한 경우에는
low에 자기 검토 루프를 더하는 편이 낫다고 합니다. - @jayleaton에 따르면, 95%의 시간은
medium을 쓰고 어려운 CUDA 커널 최적화 때만high를 씁니다. - 반대로 코딩에는
high나xhigh여야 충분하고low는 너무 약하다는 의견도 있습니다.
X의 화제 요약에는 "Anthropic이 대부분의 작업에서 high를 최적의 균형으로 권장한다"는 문장도 있습니다. 공식 문서를 살펴봤지만 Opus 5.5에 대한 그런 문장은 찾지 못했습니다. Opus 5.5의 기본값이자 출발점은 medium이고, "high가 품질과 token 효율의 최적 균형인 경우가 많다"는 문장은 Opus 4.7 권장 사항에 있습니다. 이 글은 Opus 5.5 문서를 기준으로 썼습니다.
Anthropic 공식 설명
- medium부터 시작하고 Opus 5 설정을 그대로 가져오지 않기: Opus 5.5 프롬프트 가이드에 따르면 Anthropic 테스트에서 Opus 5.5의
medium은 코딩과 지식 작업 평가에서 Opus 5의high와 같거나 더 나았고, 몇몇 코딩 평가에서는low도 그에 가까웠습니다. 같은 단계라도 Opus 5.5는 턴마다 Opus 5보다 더 많이 생각하며, 특히xhigh와max에서 두드러집니다. 예전 설정을 그대로 쓰면 턴이 길어지고 token이 늘어납니다. xhigh와max는 효과를 측정한 뒤에: 자기 작업으로 여러 단계를 시험해 보고 정하라고 권합니다. 생각을 줄이고 싶다면 프롬프트로 지시하기보다 effort를 먼저 낮추는 것이 더 확실합니다.- 블로그 저자의 사용법: 공식 블로그 claude.dev에서 Thariq Shihipar는 Spending your effort에서, 새 기능을 만들 때 Claude에게 스펙에 대해 인터뷰하게 하고
low로 구현한 뒤 직접 검토하고high로 검증과 테스트를 한다고 소개했습니다. 그의 테스트에서 effort가 높을수록 Claude는 엣지 케이스를 더 많이 시험하고 스스로 내리는 판단도 늘었습니다.low는 출발점을 빨리 돌려주므로 사람이 옆에서 지켜보며 진행하는 작업에 맞습니다.
1단계: API Key를 만들고 Claude Code 연결하기
- aicodewith.ai에 가입하고 로그인한 뒤 키 관리 화면에서 Key를 만들고, 생성될 때 표시되는 전체 문자열을 복사합니다.
- 터미널에서 주소와 Key를 설정하고 Opus 5.5로 Claude Code를 시작합니다:
export ANTHROPIC_BASE_URL="https://api.aicodewith.ai"
export ANTHROPIC_AUTH_TOKEN="YOUR_API_KEY"
claude --model claude-opus-5-5
설정을 영구 저장하거나 Windows에서 쓰거나 로그인 충돌이 생기면 Claude Code를 서드파티 API에 연결하는 방법을 참고하세요. Codex와 Cursor에서도 Claude 모델을 선택할 수 있으며 같은 글에서 다룹니다.
2단계: Claude Code에서 effort 설정하고 바꾸기
Claude Code 하단 상태 줄에 현재 단계가 표시됩니다(예: ◐ medium · /effort). 자주 쓰는 명령:
/effort status      # Effort level: auto (currently medium)
/effort high        # Set effort level to high (saved as your default for new sessions)
/effort             # interactive slider: low / medium / high / xhigh / max
/effort auto        # clear the saved level for the current model
/effort high처럼 단계를 바로 입력하거나/effort슬라이더,/model선택 화면에서 Enter를 누르면 해당 모델의 기본값으로 저장되어 재시작 후에도 유지됩니다. 슬라이더에서s를 누르면 현재 세션에만 적용됩니다.max는 저장되지 않고 현재 세션에만 적용됩니다(환경 변수로 설정한 경우 제외).- 새 단계는 다음에 보내는 메시지부터 적용됩니다.
저장된 기본값을 건드리지 않고 잠시만 바꾸려면:
# one session only
claude --model claude-opus-5-5 --effort high

# headless run (-p), this run only
claude -p "Fix the failing test" --model claude-opus-5-5 --effort low

# environment variable, overrides everything else
export CLAUDE_CODE_EFFORT_LEVEL=high
Claude Code가 단계를 정하는 우선순위는 환경 변수 CLAUDE_CODE_EFFORT_LEVEL, 세션에서 /effort나 /model로 고른 단계, 실행 옵션 --effort, settings에 저장된 값, 모델 기본값 순입니다.
함정: 예전 effortLevel은 Opus 5.5에 적용되지 않음
예전 /effort는 ~/.claude/settings.json 최상위에 effortLevel 한 줄을 썼습니다. 지금은 모델별로 저장하며, /effort high를 실행하면 파일이 이렇게 바뀝니다(실측으로 얻은 내용):
{
  "modelSettings": {
    "claude-opus-5-5": {
      "effortLevel": "high"
    }
  }
}
사용자 설정이 아직 예전 방식이라면:
{
  "effortLevel": "high"
}
실측해 보니 이 파일로 Opus 5.5를 시작하면 /effort status에 Effort level: auto (currently medium)가 표시되어 예전 high가 무시됐습니다. 같은 파일로 Opus 5를 시작하면 high였습니다. 이는 공식 문서와 같습니다. 사용자 설정 최상위의 effortLevel은 Opus 5.5 이후 모델에는 반영되지 않지만, 프로젝트, 로컬, 관리 설정 최상위의 effortLevel은 모든 모델에 적용됩니다. Opus 5에서 Opus 5.5로 옮겼다면 먼저 /effort status로 실제 단계를 확인하세요.
effort는 skill이나 서브에이전트 파일의 frontmatter에도 쓸 수 있어, 특정 skill이나 서브에이전트만 다른 단계로 돌릴 수 있습니다. 한 턴만 더 깊이 생각하게 하려면 세션 단계를 바꾸지 말고 프롬프트에 ultrathink라고 쓰면 됩니다.
3단계: API 요청에서 effort 작성법
effort는 output_config 안에 쓰며 beta 헤더는 필요 없습니다. 우리 사이트 Key를 쓰는 curl 예시:
curl https://api.aicodewith.ai/v1/messages \
  -H "x-api-key: YOUR_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-opus-5-5",
    "max_tokens": 32000,
    "output_config": { "effort": "high" },
    "messages": [{ "role": "user", "content": "Write parse_duration(s) ..." }]
  }'
Python SDK:
import anthropic

client = anthropic.Anthropic(base_url="https://api.aicodewith.ai")
resp = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=32000,
    output_config={"effort": "high"},   # low / medium / high / xhigh / max
    messages=[{"role": "user", "content": "Write parse_duration(s) ..."}],
)
text = "".join(b.text for b in resp.content if b.type == "text")  # thinking block comes first
주의할 점:
output_config.effort를 보내지 않으면 모델 기본값이 적용되며 Opus 5.5는medium입니다."medium"을 명시해도 생략한 것과 동작이 똑같습니다.- 단계가 높을수록
max_tokens를 크게 잡아야 합니다. 생각에 쓰는 token도max_tokens에 포함되기 때문입니다. Anthropic에 따르면 긴 에이전트형 코딩에는 Opus 5.5의 상한인 128000이 잘 맞았습니다. content의 첫 블록은 보통thinking입니다. 첫 블록을 바로 읽지 말고type == "text"인 블록을 찾아 읽으세요.- 대화 도중 최상위 effort를 바꾸면 프롬프트 캐시가 무효화됩니다. Opus 5.5는 메시지 단위 effort 변경(beta, 헤더
mid-conversation-output-config-2026-07-01)을 지원해 캐시를 유지할 수 있습니다. 작성법은 공식 문서를 참고하세요.
실측: 우리 사이트 Key로 단계별 테스트
테스트일은 2026년 11월 1일, 모델은 claude-opus-5-5이며 모두 우리 사이트 Key로 호출했습니다.
API: 같은 문제를 단계별로
과제는 "1h30m", "2d4h" 같은 문자열을 초 단위로 바꾸는 parse_duration(s) 함수로, 대소문자, 공백, 순서 오류, 단위 중복, 소수, 음수 등 잘못된 입력을 처리해야 합니다. 단계별 코드를 25개 케이스(정상 10개, 비정상 15개)로 채점했습니다:
| effort | 소요 시간 | 출력 token | 25개 케이스 |
|---|---|---|---|
| 지정 안 함(기본값) | 약 9.8초 | 411 | 모두 통과 |
| low | 약 9.7초 | 410 | 모두 통과 |
| medium | 약 10.7초 | 512 | 모두 통과 |
| high | 약 12.1초 | 473 | 모두 통과 |
| xhigh | 약 19.8초 | 798 | 모두 통과 |
| max | 약 258.5초 | 5980 | 모두 통과 |
지정 안 함과 low가 거의 같은 이유는 이 문제가 Opus 5.5에게 쉬워서 기본값에서도 잠깐만 생각하기 때문입니다. max에서는 4분 넘게 생각하고 출력 token이 high의 10배가 넘었지만 결과는 똑같이 25/25였습니다. max를 스트리밍 없이 보냈을 때는 4분 남짓 지나 연결이 끊겼고, 스트리밍("stream": true)으로 바꾸자 결과를 받았습니다. xhigh와 max는 스트리밍으로 쓰기를 권합니다.
Claude Code: 버그 하나를 네 단계로 수정
구간을 병합하는 함수에 버그가 있어 맞닿거나 인접한 구간이 병합되지 않고, 테스트 6개 중 2개가 실패합니다:
# ranges.py
def merge_ranges(ranges):
    """Merge overlapping or touching [start, end] integer ranges."""
    ranges = sorted(ranges)
    out = []
    for s, e in ranges:
        if out and s < out[-1][1]:
            out[-1][1] = max(out[-1][1], e)
        else:
            out.append([s, e])
    return out
Claude Code 2.1.310으로 low, medium, high, xhigh를 각각 실행했습니다:
claude -p "Fix merge_ranges in ranges.py so all tests in test_ranges.py pass, then run python3 -m unittest. Reply with one short summary line." \
  --model claude-opus-5-5 --effort high \
  --permission-mode acceptEdits --allowedTools "Bash(python3 -m unittest*)"
| effort | Enter부터 결과까지 | 결과 |
|---|---|---|
| low | 약 8.8초 | 테스트 6개 모두 통과 |
| medium | 약 10.2초 | 테스트 6개 모두 통과 |
| high | 약 14.2초 | 테스트 6개 모두 통과 |
| xhigh | 약 30.3초 | 테스트 6개 모두 통과 |
네 단계 모두 같은 한 줄을 고쳤습니다:
-        if out and s < out[-1][1]:
+        if out and s <= out[-1][1] + 1:
사용자 반응과 맞아떨어지는 결과입니다. 범위가 분명하고 테스트가 있는 작은 작업에서는 단계를 올려도 느려질 뿐 결과가 나아지지 않습니다. 단계 차이는 엣지 케이스가 많거나, 기존 테스트가 없거나, 모델이 직접 검증해야 하는 작업에서 드러납니다. 그때 단계를 올리세요.
API Key를 만들고 내 작업으로 여러 단계를 시험해 보기 →
작업별 단계 고르기
| 작업 | 시작 단계 | 메모 |
|---|---|---|
| 질문, 이름 변경, 초안, 서브에이전트 | low | 빠름. 사람이 보면서 그때그때 수정 |
| 범위가 분명한 기능 추가, 일상 개발 | medium(기본값) | Anthropic에 따르면 Opus 5의 high에 해당 |
| 기존 코드 버그 수정, 테스트로 검증하는 작업 | high | 사용자 반응에 따르면 xhigh에서 내려온 사람 대부분이 이걸로 충분 |
| 수십 분 이상의 긴 작업, 마이그레이션, 감사 | xhigh | token이 크게 늘어남. max_tokens를 크게, 스트리밍으로 |
| 보안 감사 등 Claude에게 맡기는 어려운 문제 | max | Anthropic은 과도한 생각을 경고. 작은 범위부터 시험 |
구독을 쓰는 경우 단계가 높을수록 token이 늘어 사용 한도도 빨리 줄어듭니다. API Key를 쓰는 경우 token 사용량이 단계에 따라 늘며, 요청별 사용량은 호출 기록에서 볼 수 있습니다.
자주 나오는 오류와 질문
오류 "Opus 5.5 effort 必须为 low、medium、high、xhigh 或 max"
effort에 "ultra"나 "adaptive"를 넣었더니 우리 사이트가 다음과 같이 돌려줬습니다(effort는 low, medium, high, xhigh, max 중 하나여야 한다는 뜻입니다):
HTTP 400
Opus 5.5 effort 必须为 low、medium、high、xhigh 或 max
유효한 이름은 이 다섯 개뿐입니다. adaptive는 thinking 모드이지 effort 단계가 아니며, Claude Code의 ultracode도 API 단계가 아니므로 둘 다 output_config.effort에 쓸 수 없습니다.
high로 설정했는데 Opus 5.5가 계속 medium으로 동작
대부분 위에서 설명한 예전 effortLevel 문제입니다. Opus 5.5를 선택한 상태에서 /effort high를 실행하고 /effort status로 확인하세요. 환경 변수 CLAUDE_CODE_EFFORT_LEVEL이 설정돼 있지 않은지도 확인하세요. 이 값이 가장 우선합니다.
thinking disabled나 budget_tokens를 보내면 400
effort 공식 문서와 Opus 5.5 마이그레이션 가이드에 따르면 Opus 5.5는 생각이 항상 켜져 있어 thinking: {"type": "disabled"}와 budget_tokens는 공식 API에서 거부됩니다. thinking 필드를 지우고 생각의 깊이는 effort로 조절하세요. temperature, top_p, top_k도 빼야 합니다.
답변이 중간에 잘리거나 thinking만 있고 본문이 없음
max_tokens가 너무 작아 생각하는 데 다 써 버린 경우입니다. 높은 단계에서는 max_tokens를 늘리고 긴 작업은 스트리밍으로 받으세요.
Opus 4.6이나 Sonnet 4.6에서 xhigh를 선택한 경우
이 두 모델에는 xhigh가 없습니다. Claude Code는 선택한 단계 이하에서 쓸 수 있는 가장 높은 단계로 자동으로 내리므로, Opus 4.6에서는 xhigh가 high로 동작합니다.
Fast mode와 effort는 같은 건가요?
아닙니다. effort는 모델이 얼마나 생각하고 검증할지를 정하고, Fast mode는 별도의 스위치입니다. 켜는 방법과 쓸모 있는 상황은 Claude Opus 5.5 Fast Mode 사용법을 참고하세요.
Opus 5.5를 낮은 단계로 쓸까, Sonnet 5.5로 바꿀까
둘 다 시간과 token을 아낄 수 있습니다. 어느 쪽이 맞는지는 작업에 따라 다르니 내 작업으로 둘 다 돌려 보고 비교하세요. 모델 비교는 Claude Sonnet 5.5 vs Opus 5.5에 정리했습니다.
관련 글
- Claude Opus 5.5 Fast Mode 사용법: Claude Code /fast와 오류 해결
- Claude Sonnet 5.5 vs Opus 5.5: 코딩 능력과 맞는 작업 비교
- Claude Code는 어떤 모델을 쓸까? Opus 5.5와 Sonnet 5.5 고르기
- Claude Code를 서드파티 API에 연결하는 방법: Base URL, API Key, 모델 설정
- 11월 3일부터 Claude 워터마크 적용: Claude Code와 API 출력도 표시될까?
참고 자료
- Anthropic 공식 문서: Effort
- Claude Code 문서: Model configuration(Adjust effort level)
- Anthropic: Prompting Claude Opus 5.5(Calibrate effort)
- Thariq Shihipar: Using Claude Code: Spending your effort
- Artificial Analysis: Claude Opus 5.5 takes the top spot, 그리고 xhigh vs max, high, medium vs low 비교 페이지
- Theo의 게시물, Theo의 순위 이미지, swyx, @zwb44, @jayleaton
- X의 화제 요약


