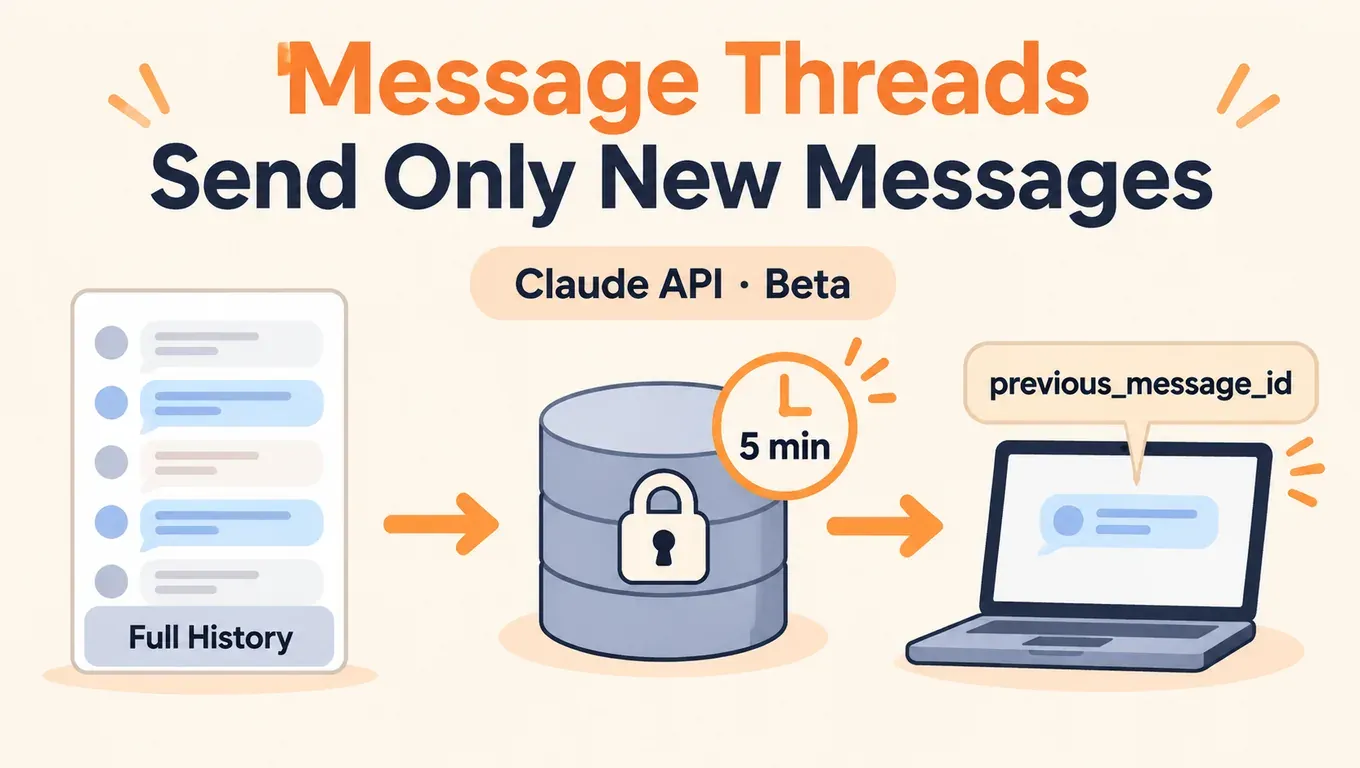
Kurz gesagt: Mit Message Threads hält die Messages API ein Gespräch kurz auf dem Server. Nach der ersten Runde sendest du nur die neuen Nachrichten und die id der vorherigen Antwort. Die Anfragen werden kleiner, und Claude beginnt in langen Gesprächen früher zu antworten. Das spart Latenz, keine Tokens.
- Laut den Release Notes von Anthropic sind Message Threads seit dem 2. November als Beta in der Messages API verfügbar. Anfragen brauchen den Beta-Header
message-threads-2026-08-12und einenthread-Parameter im Body. Ein Thread läuft 5 Minuten nach seiner letzten Anfrage ab und wird spätestens 1 Stunde nach der letzten Nutzung gelöscht. - Laut der Ankündigung von Anthropic sind Threads für die meisten Claude-Code-Nutzer bereits standardmäßig aktiv. Bei Anfragen mit 500.000 bis 1 Million Tokens sinkt die mediane Zeit bis zum ersten Token um etwa 35 %. Claude liest weiterhin in jeder Runde das ganze Gespräch, daher bleibt der Token-Verbrauch gleich, ebenso Abrechnung und Rate Limits.
- Wir haben am 3. November mit einem aicodewith-Key getestet: Über aicodewith wird das
thread-Feld derzeit ignoriert. Alle Anfragen liefern 200, aber die Fortsetzungsrunde hat keinen früheren Kontext, und das Modell kennt das vorher Gesagte nicht. Verwende über aicodewith also keine Threads, sondern sende wie gewohnt den vollständigen Verlauf mit Prompt Caching. Claude Code schickt keine Thread-Anfragen an aicodewith und funktioniert normal.
API Key erstellen und Claude in Claude Code, Codex oder Cursor verbinden →
Was sind Message Threads
Die Messages API merkt sich keine Gespräche. Ohne Thread sendet ein Agent in jeder Runde alle früheren Nachrichten und Tool-Ergebnisse erneut, und die API prüft und tokenisiert alles noch einmal. Sobald ein Gespräch Hunderttausende Tokens umfasst, verzögert schon das das erste Token.
Laut der offiziellen Doku funktioniert ein Thread so: Die erste Anfrage geht wie gewohnt raus, mit dem ganzen Gespräch, system und tools, plus "thread": {"type": "create"}. Die API speichert das Gespräch samt Claudes Antwort unter der id der Antwort. In jeder späteren Runde sendest du nur die Nachrichten seit der vorherigen Antwort, plus "thread": {"type": "continue", "previous_message_id": "..."}, und die API setzt das Gespräch vor dem Modellaufruf wieder zusammen. Die Antwort ist die übliche Message.
| Ohne Thread | Mit Thread | |
|---|---|---|
| Request-Body pro Runde | Ganzer Verlauf + system + tools | Runde 1 vollständig; danach nur neue Nachrichten + id der vorherigen Antwort |
| Zeit bis zum ersten Token | Wächst mit dem Gespräch | Niedriger und stabiler, je länger das Gespräch, desto deutlicher |
| Token-Verbrauch | Ganzes Gespräch wird jede Runde gelesen | Gleich, das ganze Gespräch wird weiter jede Runde gelesen |
| Abrechnung und Rate Limits | Standard | Unverändert |
| Wer das Gespräch hält | Deine Anwendung | Der Server für 5 Minuten; deine Anwendung behält trotzdem eine vollständige Kopie |
Außerdem sinkt laut der Zusammenfassung von @dotey nach Anthropics Zahlen die mediane Anfragegröße in langen Gesprächen von etwa 800 KB auf 1,8 KB. Die Ankündigung von @ClaudeDevs hatte am Morgen des 3. November (Pekinger Zeit) rund 209.000 Aufrufe, 3.681 Likes und 1.041 Lesezeichen und landete in den X-Trends.
So nutzt du es: thread-Parameter und Beta-Header
Jede Anfrage eines Threads braucht anthropic-beta: message-threads-2026-08-12. Die folgenden Beispiele gehen an die offizielle Anthropic API (zu aicodewith siehe weiter unten).
curl
# Turn 1: full conversation + system (+ tools), create a thread
curl -sS https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "anthropic-beta: message-threads-2026-08-12" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-opus-5-5",
    "max_tokens": 1024,
    "cache_control": {"type": "ephemeral"},
    "system": "You are a support agent for Acme. Keep replies short.",
    "messages": [{"role": "user", "content": "Hi! I have a question about an order."}],
    "thread": {"type": "create"}
  }'

# Turn 2: only the new message + the id of the turn 1 response
# (no system / tools here: the thread keeps them)
curl -sS https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "anthropic-beta: message-threads-2026-08-12" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-opus-5-5",
    "max_tokens": 1024,
    "cache_control": {"type": "ephemeral"},
    "messages": [{"role": "user", "content": "How long does standard shipping usually take?"}],
    "thread": {"type": "continue", "previous_message_id": "'"$MSG_ID"'"}
  }'
Speichere die id der ersten Antwort als MSG_ID und setze in Runde 2 damit fort. Setze immer mit der neuesten Antwort-id fort; jede id lässt sich nur einmal fortsetzen.
Python
Das offizielle SDK hat einen Thread-Helper, client.beta.messages.thread(...). Er setzt den Beta-Header, lässt system und tools bei continue-Anfragen weg und sendet bei einem 404 einmal das ganze Gespräch neu. Du kannst thread auch selbst an create übergeben:
import anthropic

client = anthropic.Anthropic()  # official API, reads ANTHROPIC_API_KEY

# Option A: the SDK thread helper (adds the beta header, replays on 404 for you)
thread = client.beta.messages.thread(
    model="claude-opus-5-5",
    max_tokens=1024,
    cache_control={"type": "ephemeral"},
    system="You are a support agent for Acme. Keep replies short.",
)
thread.send({"role": "user", "content": "Hi! I have a question about an order."})
second = thread.send({"role": "user", "content": "How long does standard shipping usually take?"})
print(second.content[-1].text)

# Option B: send the thread field yourself
first = client.beta.messages.create(
    model="claude-opus-5-5", max_tokens=1024,
    cache_control={"type": "ephemeral"},
    system="You are a support agent for Acme. Keep replies short.",
    messages=[{"role": "user", "content": "Hi! I have a question about an order."}],
    thread={"type": "create"},
    betas=["message-threads-2026-08-12"],
)
second = client.beta.messages.create(
    model="claude-opus-5-5", max_tokens=1024,
    cache_control={"type": "ephemeral"},
    messages=[{"role": "user", "content": "How long does standard shipping usually take?"}],
    thread={"type": "continue", "previous_message_id": first.id},
    betas=["message-threads-2026-08-12"],
)
TypeScript
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic(); // official API, reads ANTHROPIC_API_KEY

const thread = client.beta.messages.thread({
  model: "claude-opus-5-5",
  max_tokens: 1024,
  cache_control: { type: "ephemeral" },
  system: "You are a support agent for Acme. Keep replies short.",
});

await thread.send({ role: "user", content: "Hi! I have a question about an order." });
const second = await thread.send({
  role: "user",
  content: "How long does standard shipping usually take?",
});
for (const block of second.content) {
  if (block.type === "text") console.log(block.text);
}
Was in jede Anfrage gehört
Die offizielle Doku teilt die Felder in drei Gruppen:
| Gruppe | Felder | Regel |
|---|---|---|
| Nur bei create | system, tools | In einer continue-Anfrage, selbst als null, gibt es einen 400 |
| Fest | model, tool_choice, thinking, mcp_servers, context_management, output_config, oberstes cache_control, die Menge der anthropic-beta-Werte u. a. | In jeder Anfrage mit demselben Wert wie bei create senden, sonst 400 thread_fingerprint_mismatch |
| Pro Runde änderbar | max_tokens, stop_sequences, stream, metadata u. a. | Von Runde zu Runde änderbar |
Um System-Prompt, Tools oder Modell zu ändern, sende das ganze Gespräch in einer neuen create-Anfrage und starte einen neuen Thread.
Ablauf und erneutes Senden
Ein Thread ist Best-Effort. Er läuft 5 Minuten nach seiner letzten Anfrage ab; danach liefert eine continue-Anfrage einen 404 mit error.details.error_code = thread_not_found. Sende dann das ganze Gespräch aus deiner eigenen Kopie in einer neuen create-Anfrage und setze mit der neuen id fort. Behalte also immer eine vollständige lokale Kopie des Gesprächs und baue das erneute Senden von Anfang an ein. Der Helper des offiziellen SDK erledigt das einmal für dich.
Spart das Geld? Nein, es spart Latenz
Laut offizieller Doku ändern Threads weder Abrechnung noch Rate Limits. Die Anfragen werden kleiner, aber Claude liest jede Runde das ganze Gespräch, die Eingabe-Tokens bleiben also gleich.
Um dieselben Tokens nicht erneut zu verarbeiten, brauchst du Prompt Caching. Ein Thread cacht nichts für dich: Die offiziellen Beispiele senden in jeder Anfrage ein oberstes cache_control: {"type": "ephemeral"}, sodass jede Runde das bisherige Gespräch aus dem Cache liest und die neue Runde hineinschreibt. Beides ergänzt sich: Der Thread spart den Upload, der Cache spart die erneute Verarbeitung.
Laut Anthropics Ankündigung passt das besonders zu lang laufenden Coding-Agents, Computer-Use-Agents mit einem Screenshot pro Runde und Gesprächen mit vielen Dokumenten und Bildern. Bei kurzen Chats ist der Gewinn klein.
Was sich in Claude Code ändert
Laut der Ankündigung von Anthropic sind Threads für die meisten Claude-Code-Nutzer bereits standardmäßig aktiv; daher stammt die Zahl von 35 %. Du musst keine Einstellung ändern.
Wir haben mit einem lokalen Proxy mitgeschnitten, welche Anfragen Claude Code 2.1.316 sendet, wenn es über ein eigenes ANTHROPIC_BASE_URL auf aicodewith zeigt. Eine Aufgabe, die zwei Dateien las, erzeugte 3 Anfragen, und keine enthielt ein thread-Feld oder message-threads-2026-08-12 im Beta-Header. Die Nachrichtenzahl stieg von 2 über 4 auf 6, jede Anfrage trug den ganzen Verlauf (etwa 46 KB), und die Aufgabe lief normal durch. Mit einer Drittanbieter-Base-URL arbeitet Claude Code also wie bisher und wird durch Threads nicht gestört.
Einrichtung:
export ANTHROPIC_BASE_URL="https://api.aicodewith.ai"
export ANTHROPIC_AUTH_TOKEN="IHR_API_KEY"
claude --model claude-opus-5-5
Für dauerhafte Einstellungen und Windows siehe Claude Code mit einer Drittanbieter-API verbinden. Für etwas mehr Tempo in langen Sitzungen kannst du den Effort senken, siehe Claude Opus 5.5 Effort richtig wählen.
Message Threads sind eine Funktion der Claude Messages API; Codex spricht mit der API von OpenAI und ist nicht betroffen. Auch das Codex SDK kennt „Threads“, aber die setzen eine clientseitige Sitzung fort, was etwas anderes ist als diese serverseitige Speicherung. Siehe Einstieg in das Codex SDK: TypeScript-Aufrufe, Streaming-Events und Thread-Fortsetzung.
Funktioniert es über aicodewith? Testergebnisse
Früh am 3. November 2026 (Pekinger Zeit) haben wir den Anthropic-kompatiblen Endpunkt von aicodewith, https://api.aicodewith.ai/v1/messages, mit einem aicodewith-Key, dem Modell claude-opus-5-5 und dem Header message-threads-2026-08-12 aufgerufen und die offiziellen Beispiele Fall für Fall durchgespielt:
| Test | Erwartet bei der offiziellen API | Tatsächlich über aicodewith |
|---|---|---|
| create: ganzes Gespräch + thread: create | 200, Thread angelegt | 200, normale Antwort |
| continue: neue Nachricht + vorherige id | 200, Modell sieht frühere Runden | 200, aber input_tokens = 27, keine früheren Runden sichtbar |
| dieselbe id ein zweites Mal fortsetzen | 400 thread_already_continued | 200 |
| nicht existierende previous_message_id | 404 thread_not_found | 200 |
| continue mit system | 400 | 200 |
| Thread-Helper im Python SDK 2.4.0 | Runde 2 erinnert sich an Runde 1 | Runde 2 sagt, es gebe keine Bestellnummer |
Die echte Antwort in der Fortsetzungsrunde (Auszug):
Turn 1 (create):  "Hi! I have a question about an order."
  -> 200, "Happy to help. What's your order number, and what's the question about it?"
Turn 2 (continue, previous_message_id = turn 1 id):
  "How long does standard shipping usually take? Also, what did I say my question was about?"
  -> 200, input_tokens: 27
  -> "...As for your question, you didn't say what it was about beyond asking about standard shipping..."
Fazit: aicodewith unterstützt Message Threads noch nicht und behandelt das thread-Feld, als wäre es nicht da; jede Anfrage wird für sich verarbeitet. Tückisch ist, dass nichts fehlschlägt: Der SDK-Helper bekommt nie einen 404, sendet nie neu, und das Gespräch verliert still seinen Kontext. Über aicodewith also kein thread in Anfragen und kein client.beta.messages.thread(...).
Ausweg: ganzer Verlauf + Prompt Caching
Sende wie gewohnt in jeder Runde den ganzen Verlauf und füge ein oberstes cache_control hinzu, um automatisches Caching einzuschalten. Wir haben mit demselben aicodewith-Key drei Runden gefahren (System-Prompt mit etwa 7.500 Tokens):
| Runde | Eingabe (nicht gecacht) | Cache geschrieben | Cache gelesen | Dauer | Antwort |
|---|---|---|---|---|---|
| 1 | 24 | 7.568 | 0 | 4,0 s | Normal |
| 2 | 8 | 1.541 | 6.163 | 4,4 s | Normal |
| 3 | 8 | 1.560 | 6.240 | 3,5 s | „Your order number is A-1042.“ |
Runde 2 und 3 trafen den Cache, und Runde 3 nannte korrekt die Bestellnummer aus Runde 1. In Python:
import anthropic

client = anthropic.Anthropic(
    base_url="https://api.aicodewith.ai",
    api_key="IHR_API_KEY",
)

SYSTEM = "You are a support agent for Acme. Keep replies short.\n\n" + open("policy.md").read()
history = [{"role": "user", "content": "Hi! My order number is A-1042 and it hasn't shipped yet."}]

def turn(next_user_message=None):
    r = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        cache_control={"type": "ephemeral"},  # automatic caching: moves forward each turn
        system=SYSTEM,
        messages=history,                       # full history, no thread field
    )
    history.append({"role": "assistant", "content": [b.model_dump(exclude_none=True) for b in r.content]})
    if next_user_message:
        history.append({"role": "user", "content": next_user_message})
    u = r.usage
    print(u.input_tokens, u.cache_creation_input_tokens, u.cache_read_input_tokens)
    return r

turn("When will it ship?")
turn("What was my order number again?")
turn()
In TypeScript gleich, mit dem ganzen Verlauf in messages:
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic({
  baseURL: "https://api.aicodewith.ai",
  apiKey: "IHR_API_KEY",
});

const history: Anthropic.MessageParam[] = [
  { role: "user", content: "Hi! My order number is A-1042 and it hasn't shipped yet." },
];

const r = await client.messages.create({
  model: "claude-opus-5-5",
  max_tokens: 1024,
  cache_control: { type: "ephemeral" },
  system: "You are a support agent for Acme. Keep replies short.",
  messages: history, // full history every turn, no thread field
});
history.push({ role: "assistant", content: r.content });
console.log(r.usage);
Prüfen, ob ein Endpunkt Threads wirklich unterstützt
Sende eine continue-Anfrage mit einer previous_message_id, die es nicht geben kann. Die offizielle API liefert 404 thread_not_found; ein 200 mit normaler Antwort heißt, dass der Endpunkt thread ignoriert:
# continue from an id that cannot exist
curl -sS https://api.aicodewith.ai/v1/messages \
  -H "x-api-key: IHR_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "anthropic-beta: message-threads-2026-08-12" \
  -H "content-type: application/json" \
  -d '{"model":"claude-opus-5-5","max_tokens":200,"cache_control":{"type":"ephemeral"},
       "messages":[{"role":"user","content":"Hi"}],
       "thread":{"type":"continue","previous_message_id":"msg_doesnotexist123"}}'
# official API: 404, error.details.error_code = "thread_not_found"
# a gateway that ignores thread: 200 and a normal reply
Sobald aicodewith Threads unterstützt, zeigt dieser Befehl das, ohne dass du deinen Anwendungscode anfassen musst.
Häufige Fehler
Laut offizieller Doku kommen diese Fehler, bevor das Modell läuft. Sie verbrauchen keine Tokens, und Thread und Ablaufzeit bleiben unverändert.
404 thread_not_found
Der Thread ist abgelaufen (5 Minuten keine Anfrage), die vorherige Runde wurde nicht gespeichert, ein Fallback-Modell hat die vorherige Antwort geschrieben, sie wird noch generiert, oder die Anfrage nutzt einen anderen API Key, eine andere Organisation oder einen anderen Workspace. Lösung: das ganze Gespräch in einer neuen create-Anfrage senden. Auch eine Anfrage an ein nicht existierendes Modell liefert 404, prüfe also error.details.error_code, bevor du neu sendest:
{
  "type": "error",
  "error": {
    "type": "not_found_error",
    "message": "...",
    "details": { "error_code": "thread_not_found" }
  },
  "request_id": "req_..."
}
400 thread_fingerprint_mismatch
Ein festes Feld weicht von der create-Anfrage ab, etwa ein anderes model oder thinking, ein geändertes oberstes cache_control oder ein Beta-Header mehr oder weniger. Die Fehlermeldung nennt die Felder. Zum Ändern einen neuen Thread starten.
400 thread_already_continued / thread_continue_in_flight
Jede Antwort-id lässt sich nur einmal fortsetzen, oder eine frühere continue-Anfrage läuft noch. Setze immer mit der neuesten id fort. Beim Streaming erst nach dem Event message_stop fortsetzen; früher kann einen 404 liefern.
400 thread_unsupported_request
Die Anfrage nutzt etwas, das Threads nicht unterstützen: mehr als 4 cache_control-Breakpoints (der oberste zählt mit), Compaction auf Abruf, die meisten Context-Editing-Varianten oder eine Organisation mit HIPAA oder Inference Hooks. Auch Message Batches und Token-Zählung nehmen kein thread an. Entferne die Funktion oder sende das ganze Gespräch ohne thread.
Eine continue-Anfrage enthält system oder tools
Liefert einen 400 ohne error_code. Bei continue nur die neuen Nachrichten senden; system und tools hält der Thread.
Über aicodewith hat die Fortsetzungsrunde den Kontext verloren
Das liegt daran, dass aicodewith thread derzeit ignoriert, ohne Fehler. Entferne thread und gehe zurück zu ganzem Verlauf + cache_control, wie oben gezeigt.
Datenaufbewahrung und Grenzen
- Laut offizieller Doku liegt ein Thread verschlüsselt im Arbeitsspeicher, wird nie dauerhaft gespeichert und spätestens 1 Stunde nach der letzten Nutzung gelöscht. Threads sind nicht für Zero Data Retention (ZDR) oder HIPAA geeignet.
- Es gibt keine API, um einen Thread aufzulisten, zu lesen oder zu löschen.
- Verfügbar auf der Claude API, Claude Platform on AWS, Claude Models on Google Cloud (Anthropic managed) und Claude in Microsoft Foundry, auf allen Modellen als Beta.
- Unabhängig davon deckt laut Berichten das Text-Wasserzeichen von Claude ab dem 3. November mehr Modelle ab; das hat nichts mit Threads zu tun und braucht keine Änderung an Anfragen, siehe Claude-Wasserzeichen ab 3. November.
Fazit
Message Threads beheben die Latenz, die entsteht, wenn jede Runde den ganzen Verlauf neu hochlädt: In der ersten Runde einen Thread anlegen, danach nur neue Nachrichten und die vorherige Antwort-id senden. Das erste Token kommt früher, Token-Verbrauch und Abrechnung bleiben gleich, und du behältst trotzdem eine vollständige lokale Kopie, um nach dem Ablauf von 5 Minuten neu zu senden. Für lang laufende Agents an der offiziellen API lohnt es sich. Über aicodewith wird thread derzeit ignoriert, also den ganzen Verlauf mit cache_control senden; Claude Code mit aicodewith braucht keine Änderung.
API Key erstellen und in Claude Code, Codex oder Cursor loslegen →