
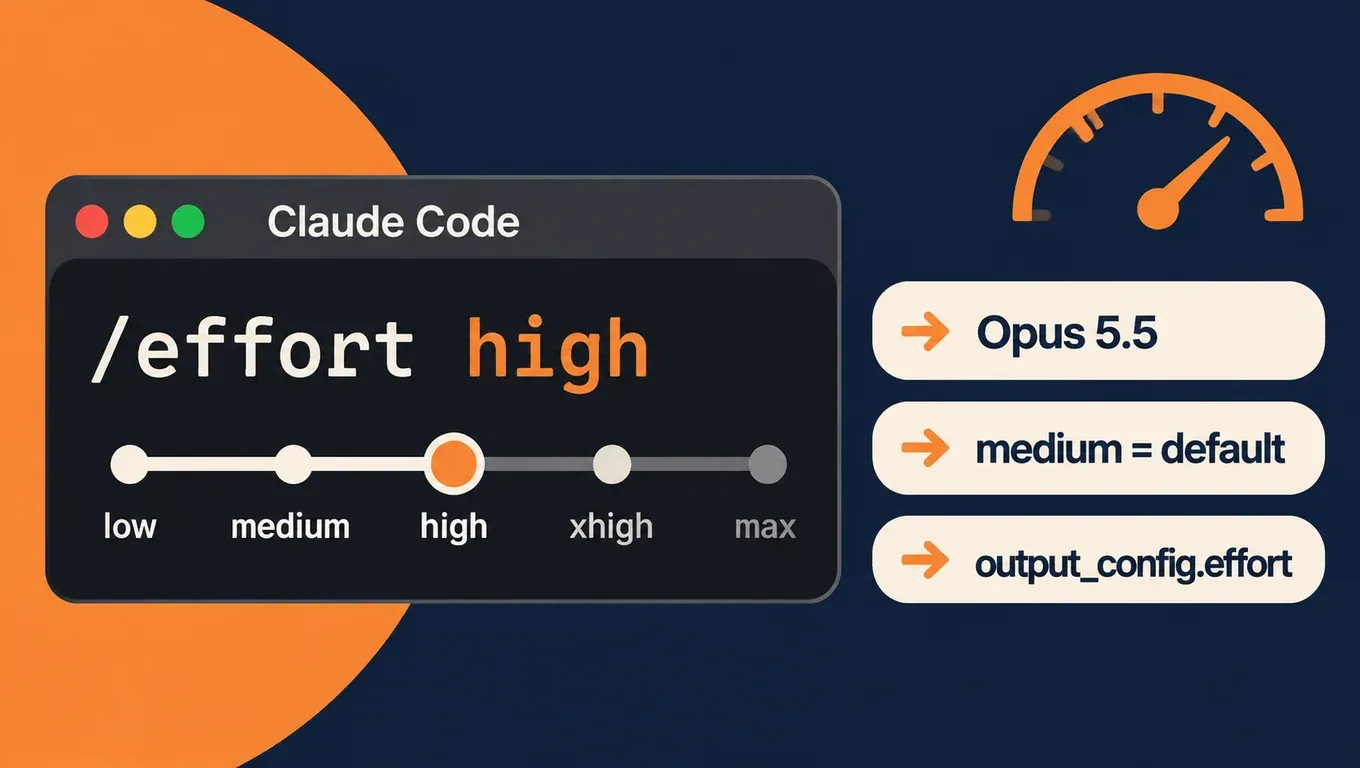
Kurz gesagt: Effort steuert, wie lange Opus 5.5 nachdenkt und wie viel es selbst überprüft. Es gibt fünf Stufen, low, medium, high, xhigh und max, und der Standard ist medium, eine Stufe unter dem Standard high von Opus 5.
- Für klar umrissene Alltagsarbeit wie das Umsetzen eines Features reicht der Standard
medium. Für Bugfixes in einer bestehenden Codebasis und Aufgaben mit vielen Randfällen wechseln Sie zuhigh.xhighundmaxheben Sie für lange Aufgaben auf, bei denen das Modell selbst prüfen muss. So teilt es die Claude-Code-Dokumentation ein. - Laut Nutzerberichten sehen viele, die Opus 5.5 von
xhighaufhighgestellt haben, gleich gute oder bessere Ergebnisse. Artificial Analysis hat fürxhighüber die gesamte Testreihe etwa 100M Ausgabe-Tokens gemessen, fürhigh56M: rund 1,8-mal so viele Tokens für 5 Punkte mehr (57 zu 52). - Eine Falle in Claude Code: Die alte Zeile
"effortLevel": "high"auf oberster Ebene von~/.claude/settings.jsongilt nicht für Opus 5.5, es läuft weiter mitmedium. Führen Sie unter Opus 5.5 einmal/effort highaus, dann speichert Claude Code die Stufe pro Modell untermodelSettings. Das haben wir selbst getestet. - In der API senden Sie
"output_config": {"effort": "high"}. Ohne das Feld giltmedium.
API Key erstellen und Opus 5.5 in Claude Code, Codex oder Cursor nutzen →
Was die fünf Stufen bedeuten
Effort ist kein festes Token-Limit. Es sagt dem Modell, wie viel Arbeit eine Aufgabe verdient, und beeinflusst damit Denkzeit, Antwortlänge und Zahl der Tool-Aufrufe. Laut offizieller Dokumentation denkt Claude auch auf niedrigen Stufen bei ausreichend schweren Problemen nach, nur weniger. Bei Opus 5.5 ist adaptives Denken immer aktiv und lässt sich nicht abschalten, daher ist Effort der wichtigste Regler für die Denktiefe.
Die Tabelle stellt Anthropics Empfehlungen den Ergebnissen von Artificial Analysis je Stufe im Intelligence Index v5 gegenüber (siehe die Vergleichsseiten low / medium, high und xhigh / max):
| Stufe | Einsatz laut Anthropic | AA-Index | Ausgabe-Tokens für die ganze Testreihe | Durchschnittliche Zeit pro Aufgabe |
|---|---|---|---|---|
| low | Brainstorming, erste Entwürfe, kleine Änderungen wie Umbenennen; Subagents | 35 | etwa 21M | etwa 153 s |
| medium (Standard) | Klar umrissene Alltagsarbeit wie ein neues Feature | 48 | etwa 43M | etwa 347 s |
| high | Arbeit, bei der Prüfung wichtig ist oder Randfälle wahrscheinlich sind, etwa ein Bugfix in bestehendem Code | 52 | etwa 56M | etwa 474 s |
| xhigh | Tieferes Nachdenken; lange Aufgaben über 30 Minuten | 57 | etwa 100M | etwa 793 s |
| max | Schwere Probleme, die Claude allein lösen soll, etwa Sicherheitslücken finden; neigt zum Überdenken | 58 | etwa 218M | etwa 1141 s |
Von high auf xhigh braucht es rund 1,8-mal so viele Tokens für 5 Punkte. Von xhigh auf max verdoppeln sich die Tokens noch einmal mehr als für 1 Punkt. AA weist außerdem darauf hin, dass medium, high, xhigh und max alle auf seiner Pareto-Front aus Intelligenz und Aufwand pro Aufgabe liegen: Jede dieser vier Stufen hat passende Einsätze, keine ist pauschal die beste.
Warum viele den Effort senken
Die Diskussion begann am 31. Oktober. Laut Theo (t3.gg) hat ihn sein Kollege Julius ein, zwei Wochen zuvor überzeugt, Opus 5.5 von extra high auf high zu stellen, und das sei „fast immer besser“. Am nächsten Tag veröffentlichte er eine Rangliste der Effort-Stufen mit high ganz oben, medium und xhigh dahinter und max am Ende.
Weitere typische Reaktionen:
- Laut @zwb44, der die AA-Zahlen als Grafik aufbereitet hat: „xhigh: 1,8-mal die Tokens für 5 Punkte mehr“; nach dem Wechsel auf
highals Hauptstufe sei der Unterschied bei Verbrauch und Tempo deutlich spürbar. - Laut swyx können Nutzer mit begrenztem Durchsatz noch weiter gehen:
lowplus eine Kritikschleife. - Laut @jayleaton nutzt er zu 95 %
mediumund greift nur bei schwierigen CUDA-Kernel-Optimierungen zuhigh. - Andere halten dagegen, dass zum Programmieren nur
highoderxhightaugt undlowzu schwach ist.
In der X-Zusammenfassung steht außerdem, „Anthropic empfiehlt high als beste Balance für die meiste Arbeit“. Wir haben die offizielle Dokumentation durchgesehen und diese Aussage für Opus 5.5 nicht gefunden. Opus 5.5 startet mit medium; der Satz, dass high oft die beste Balance aus Qualität und Token-Effizienz sei, steht in den Empfehlungen für Opus 4.7. Dieser Artikel folgt der Dokumentation zu Opus 5.5.
Was Anthropic sagt
- Mit medium anfangen, Einstellungen von Opus 5 nicht übernehmen: Der Prompting-Leitfaden zu Opus 5.5 sagt, dass Opus 5.5 auf
mediumin Anthropics Tests Opus 5 aufhighbei Programmier- und Wissensarbeit erreicht oder übertrifft und bei mehreren Programmier-Evaluationenlownahe herankommt. Auf gleicher Stufe denkt Opus 5.5 pro Runde mehr als Opus 5, vor allem beixhighundmax; wer die alte Einstellung behält, bekommt längere Runden und mehr Tokens. xhighundmaxnur nutzen, wo ein Gewinn gemessen wurde: Testen Sie mehrere Stufen mit eigenen Aufgaben, bevor Sie sich festlegen. Für weniger Denken senken Sie zuerst den Effort; das wirkt zuverlässiger als Anweisungen im Prompt.- Wie der Blog-Autor es macht: Im offiziellen claude.dev-Blog schreibt Thariq Shihipar in Spending your effort, dass er sich bei neuen Features von Claude zur Spezifikation befragen lässt, auf
lowumsetzt, das Ergebnis prüft und dann aufhighverifiziert und testet. In seinen Tests prüfte Claude bei höherem Effort mehr Randfälle und traf mehr Entscheidungen selbst;lowliefert schneller einen Ausgangspunkt, passend, wenn Sie jeden Schritt begleiten.
Schritt 1: API Key erstellen und Claude Code verbinden
- Registrieren Sie sich bei aicodewith.ai, öffnen Sie die Schlüsselverwaltung, erstellen Sie einen Key und kopieren Sie die vollständige Zeichenfolge, die beim Erstellen angezeigt wird.
- Setzen Sie Basis-URL und Key im Terminal und starten Sie Claude Code mit Opus 5.5:
export ANTHROPIC_BASE_URL="https://api.aicodewith.ai"
export ANTHROPIC_AUTH_TOKEN="IHR_API_KEY"
claude --model claude-opus-5-5
Für eine dauerhafte Einrichtung, Windows oder Login-Konflikte siehe Claude Code mit einer Drittanbieter-API verbinden. Auch Codex und Cursor können Claude-Modelle nutzen; derselbe Artikel erklärt das.
Schritt 2: Effort in Claude Code setzen und wechseln
Die Fußzeile von Claude Code zeigt die aktuelle Stufe, zum Beispiel ◐ medium · /effort. Die wichtigsten Befehle:
/effort status      # Effort level: auto (currently medium)
/effort high        # Set effort level to high (saved as your default for new sessions)
/effort             # interactive slider: low / medium / high / xhigh / max
/effort auto        # clear the saved level for the current model
- Eine nach
/effortgetippte Stufe oder Enter im/effort-Schieberegler bzw. in der/model-Auswahl wird als Standard für dieses Modell gespeichert und bleibt nach einem Neustart erhalten. Mitsim Schieberegler gilt sie nur für die laufende Sitzung. maxwird nie gespeichert; es gilt nur für die laufende Sitzung, außer Sie setzen es über die Umgebungsvariable.- Die neue Stufe gilt ab Ihrer nächsten Nachricht.
Vorübergehend wechseln, ohne den gespeicherten Standard zu ändern:
# one session only
claude --model claude-opus-5-5 --effort high

# headless run (-p), this run only
claude -p "Fix the failing test" --model claude-opus-5-5 --effort low

# environment variable, overrides everything else
export CLAUDE_CODE_EFFORT_LEVEL=high
Claude Code wählt die Stufe in dieser Reihenfolge: Umgebungsvariable CLAUDE_CODE_EFFORT_LEVEL, dann die in der Sitzung mit /effort oder /model gewählte Stufe, dann der Startparameter --effort, dann Ihre Einstellungen, dann der Modellstandard.
Falle: der alte effortLevel-Schlüssel wird für Opus 5.5 ignoriert
Früher schrieb /effort eine einzelne Zeile effortLevel auf oberster Ebene in ~/.claude/settings.json. Heute speichert Claude Code die Stufe pro Modell. Nach /effort high sah unsere Datei so aus:
{
  "modelSettings": {
    "claude-opus-5-5": {
      "effortLevel": "high"
    }
  }
}
Wenn Ihre Benutzereinstellungen noch die alte Form haben:
{
  "effortLevel": "high"
}
In unserem Test zeigte Opus 5.5 mit dieser Datei in /effort status den Wert Effort level: auto (currently medium), das alte high wurde also ignoriert. Opus 5 mit derselben Datei zeigte high. Das deckt sich mit der Dokumentation: Ein effortLevel auf oberster Ebene in den Benutzereinstellungen zählt für Opus 5.5 und neuere Modelle nicht, während ein solcher Eintrag in Projekt-, lokalen oder verwalteten Einstellungen für alle Modelle gilt. Führen Sie nach dem Wechsel von Opus 5 auf Opus 5.5 /effort status aus, um zu sehen, auf welcher Stufe Sie wirklich sind.
Sie können effort auch im Frontmatter eines Skills oder Subagents setzen, damit dieser mit eigener Stufe läuft. Für tieferes Nachdenken in nur einer Runde schreiben Sie ultrathink in den Prompt, statt die Sitzungsstufe zu ändern.
Schritt 3: Effort in einer API-Anfrage setzen
Effort gehört in output_config und braucht keinen Beta-Header. Mit unserem Key als curl:
curl https://api.aicodewith.ai/v1/messages \
  -H "x-api-key: IHR_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-opus-5-5",
    "max_tokens": 32000,
    "output_config": { "effort": "high" },
    "messages": [{ "role": "user", "content": "Write parse_duration(s) ..." }]
  }'
Python SDK:
import anthropic

client = anthropic.Anthropic(base_url="https://api.aicodewith.ai")
resp = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=32000,
    output_config={"effort": "high"},   # low / medium / high / xhigh / max
    messages=[{"role": "user", "content": "Write parse_duration(s) ..."}],
)
text = "".join(b.text for b in resp.content if b.type == "text")  # thinking block comes first
Worauf Sie achten sollten:
- Ohne
output_config.effortgilt der Modellstandard, bei Opus 5.5medium."medium"explizit zu senden, verhält sich genau gleich. - Je höher die Stufe, desto größer sollte
max_tokenssein: Denk-Tokens zählen zumax_tokens. Laut Anthropic funktioniert 128000, das Maximum von Opus 5.5, gut für lange agentische Programmierrunden. - Der erste Block in
contentist meistthinking. Lesen Sie die Antwort über Blöcke mittype == "text", nicht einfach den ersten Block. - Den Effort auf oberster Ebene mitten im Gespräch zu ändern, macht den Prompt-Cache ungültig. Opus 5.5 unterstützt eine Effort-Änderung pro Nachricht (Beta, Header
mid-conversation-output-config-2026-07-01), die den Cache erhält; siehe offizielle Dokumentation.
Test: alle Stufen über unseren API Key
Getestet am 1. November 2026 mit claude-opus-5-5, alle Aufrufe über unseren Key.
API: eine Aufgabe auf jeder Stufe
Aufgabe war eine Funktion parse_duration(s), die Zeichenketten wie "1h30m" oder "2d4h" in Sekunden umrechnet und dabei Groß-/Kleinschreibung, Leerzeichen, falsche Reihenfolge, doppelte Einheiten, Dezimalzahlen, negative Zahlen und andere ungültige Eingaben behandelt. Wir haben den Code jeder Stufe mit 25 Fällen bewertet (10 gültig, 15 ungültig):
| effort | Zeit | Ausgabe-Tokens | 25 Fälle |
|---|---|---|---|
| nicht gesetzt (Standard) | etwa 9,8 s | 411 | alle bestanden |
| low | etwa 9,7 s | 410 | alle bestanden |
| medium | etwa 10,7 s | 512 | alle bestanden |
| high | etwa 12,1 s | 473 | alle bestanden |
| xhigh | etwa 19,8 s | 798 | alle bestanden |
| max | etwa 258,5 s | 5980 | alle bestanden |
Standard und low lagen fast gleich, weil die Aufgabe für Opus 5.5 leicht ist und selbst die Standardstufe nur kurz nachdenkt. Auf max dachte das Modell über vier Minuten nach und erzeugte mehr als zehnmal so viele Ausgabe-Tokens wie high, bei demselben 25/25. Unsere max-Anfrage ohne Streaming wurde nach gut vier Minuten getrennt; mit Streaming ("stream": true) kam das Ergebnis an, daher für xhigh und max Streaming verwenden.
Claude Code: ein Bugfix auf vier Stufen
Eine Funktion zum Zusammenführen von Bereichen hatte einen Fehler: Sich berührende und benachbarte Bereiche wurden nicht zusammengeführt, 2 von 6 Tests schlugen fehl:
# ranges.py
def merge_ranges(ranges):
    """Merge overlapping or touching [start, end] integer ranges."""
    ranges = sorted(ranges)
    out = []
    for s, e in ranges:
        if out and s < out[-1][1]:
            out[-1][1] = max(out[-1][1], e)
        else:
            out.append([s, e])
    return out
Wir haben Claude Code 2.1.310 mit low, medium, high und xhigh ausgeführt:
claude -p "Fix merge_ranges in ranges.py so all tests in test_ranges.py pass, then run python3 -m unittest. Reply with one short summary line." \
  --model claude-opus-5-5 --effort high \
  --permission-mode acceptEdits --allowedTools "Bash(python3 -m unittest*)"
| effort | Von Enter bis Ergebnis | Ergebnis |
|---|---|---|
| low | etwa 8,8 s | alle 6 Tests bestanden |
| medium | etwa 10,2 s | alle 6 Tests bestanden |
| high | etwa 14,2 s | alle 6 Tests bestanden |
| xhigh | etwa 30,3 s | alle 6 Tests bestanden |
Alle vier Stufen änderten dieselbe Zeile:
-        if out and s < out[-1][1]:
+        if out and s <= out[-1][1] + 1:
Das passt zu den Nutzerberichten: Bei einer kleinen, klar umrissenen Aufgabe mit Tests macht eine höhere Stufe die Arbeit nur langsamer, nicht besser. Der Unterschied zeigt sich bei Aufgaben mit vielen Randfällen, ohne vorhandene Tests oder wenn das Modell selbst prüfen muss. Dann lohnt es sich, hochzugehen.
API Key erstellen und eigene Aufgaben auf mehreren Stufen testen →
Welche Stufe passt
| Aufgabe | Startstufe | Hinweise |
|---|---|---|
| Fragen, Umbenennungen, Entwürfe, Subagents | low | Schnell; Sie prüfen und steuern jeden Schritt |
| Klar umrissene Features, Alltagsentwicklung | medium (Standard) | Laut Anthropic so gut wie Opus 5 auf high |
| Bugfixes in bestehendem Code mit Tests | high | Laut Nutzerberichten reicht das den meisten, die von xhigh heruntergegangen sind |
| Lange Aufgaben, Migrationen, Audits | xhigh | Deutlich mehr Tokens; großes max_tokens und Streaming |
| Sicherheitsprüfungen und schwere Probleme, die Claude allein löst | max | Anthropic warnt vor Überdenken; erst im kleinen Rahmen testen |
Im Abo verbrauchen höhere Stufen mehr Tokens und damit Ihr Kontingent schneller. Mit einem API Key steigt der Token-Verbrauch mit der Stufe; Sie sehen ihn pro Anfrage in Ihrem Aufrufprotokoll.
Häufige Fehler und Fragen
Fehler „Opus 5.5 effort 必须为 low、medium、high、xhigh 或 max“
Als wir "ultra" oder "adaptive" als Effort gesendet haben, antwortete unser Endpunkt (die Meldung bedeutet, dass Effort low, medium, high, xhigh oder max sein muss):
HTTP 400
Opus 5.5 effort 必须为 low、medium、high、xhigh 或 max
Nur diese fünf Namen sind gültig. adaptive ist ein Denkmodus, keine Effort-Stufe, und ultracode aus Claude Code ist ebenfalls keine API-Stufe; beides gehört nicht in output_config.effort.
Ich habe high gesetzt, aber Opus 5.5 läuft weiter auf medium
Meist ist es das oben beschriebene Problem mit dem alten effortLevel. Führen Sie unter Opus 5.5 /effort high aus und prüfen Sie mit /effort status. Prüfen Sie auch, ob CLAUDE_CODE_EFFORT_LEVEL gesetzt ist, denn es hat Vorrang vor allem anderen.
thinking disabled oder budget_tokens liefert 400
Laut Effort-Dokumentation und Opus-5.5-Migrationsleitfaden ist Denken bei Opus 5.5 immer aktiv, und thinking: {"type": "disabled"} sowie budget_tokens werden von der offiziellen API abgelehnt. Entfernen Sie das Feld thinking und steuern Sie die Denktiefe über Effort. Entfernen Sie auch temperature, top_p und top_k.
Die Antwort bricht ab oder enthält nur Denken
max_tokens ist zu klein und wurde vom Denken aufgebraucht. Erhöhen Sie max_tokens auf hohen Stufen und streamen Sie lange Aufgaben.
xhigh auf Opus 4.6 oder Sonnet 4.6 wählen
Diese beiden Modelle haben kein xhigh. Claude Code fällt auf die höchste verfügbare Stufe bis zur gewählten zurück, xhigh läuft auf Opus 4.6 also als high.
Ist der Fast Mode dasselbe wie Effort?
Nein. Effort bestimmt, wie viel das Modell nachdenkt und prüft; der Fast Mode ist ein eigener Schalter. Wie Sie ihn aktivieren und wann er hilft, steht in Claude Opus 5.5 Fast Mode nutzen.
Opus 5.5 auf niedriger Stufe oder gleich Sonnet 5.5?
Beides spart Zeit und Tokens. Was passt, hängt von der Aufgabe ab, also testen Sie eigene Aufgaben mit beiden und vergleichen Sie. Zum Modellvergleich siehe Claude Sonnet 5.5 vs Opus 5.5.
Weiterlesen
- Claude Opus 5.5 Fast Mode in Claude Code nutzen
- Claude Sonnet 5.5 vs Opus 5.5 beim Programmieren
- Welches Modell für Claude Code: Opus 5.5 oder Sonnet 5.5
- Claude Code mit einer Drittanbieter-API verbinden: Basis-URL, API Key und Modelle
- Claude-Text-Wasserzeichen ab 3. November: Werden Ausgaben von Claude Code und API markiert?
Quellen
- Anthropic-Dokumentation: Effort
- Claude-Code-Dokumentation: Model configuration (Adjust effort level)
- Anthropic: Prompting Claude Opus 5.5 (Calibrate effort)
- Thariq Shihipar: Using Claude Code: Spending your effort
- Artificial Analysis: Claude Opus 5.5 takes the top spot sowie die Vergleichsseiten xhigh vs max, high und medium vs low
- Beiträge von Theo, Theos Rangliste, swyx, @zwb44 und @jayleaton
- Die Zusammenfassung des Themas auf X


