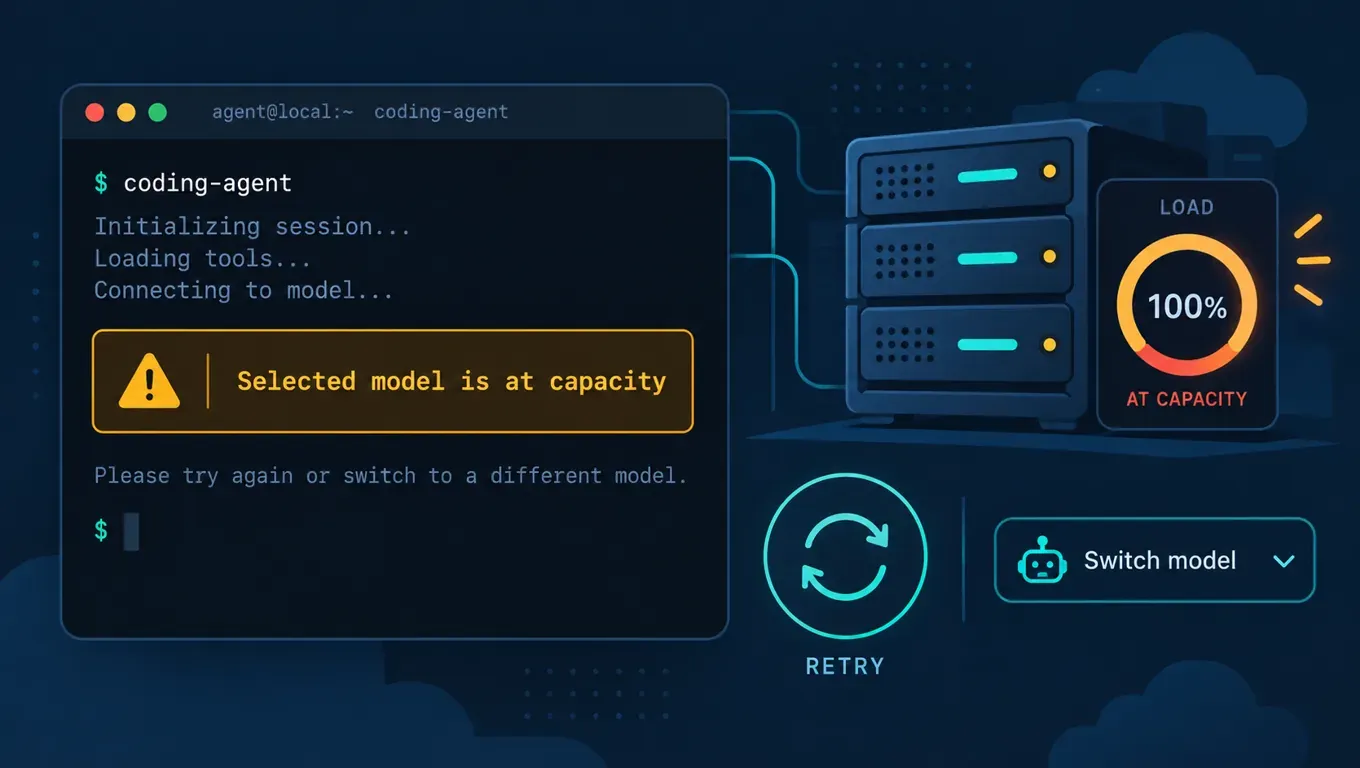
先说结论:Codex 弹出 「Selected model is at capacity. Please try a different model.」,意思是你选的模型那边服务器满载了,不是你的额度用完,也不是账号出了问题。在 Codex 源码里,它对应的是服务端返回的 HTTP 503,错误码 server_is_overloaded。
所以处理思路很简单:先确认额度还在,然后要么等它自动续跑,要么换个模型,长任务可以调大重试次数或改用 API Key 走 Provider。下面一步步来。
这个报错到底是什么意思
Codex 里有三种经常被混在一起的报错,处理办法完全不同:
| 报错类型 | 你看到的样子 | 是什么原因 | 怎么办 |
|---|---|---|---|
| 模型满载(ServerOverloaded) | Selected model is at capacity / 503 | 服务端算力不够,不是你的问题 | 等一等、换模型、调大重试 |
| 请求太快(RateLimitExceeded) | 429 Too Many Requests | 短时间请求过多被限流 | 降低频率,按 Retry-After 等待 |
| 额度用完(UsageLimitReached) | You've hit your usage limit 一类提示 | 套餐的使用窗口或额度耗尽 | 等额度重置或升级套餐 |
还有一点很多人不知道:看到这句报错时,Codex 其实已经替你重试过好几次了。它会遵守服务端返回的 Retry-After 等待时间,重试次数用完还是失败,才把这句话显示出来。所以别狂按回车,那只会让情况更糟。
这次报错高发是有背景的:10 月中旬 GitHub 上集中出现了一批同类反馈(如 #53589、#53256、#53843、#54283)。10 月 15 日 Codex 负责人 Tibo 在 X 上表示,官方已经上线一系列改动并增加算力,这个报错会明显减少;即便出现,Codex 也会自己继续往下跑,而不是卡住不动。
第 1 步:先确认不是额度用完
在 Codex 会话里输入:
/status
用 Codex App 的话,到 Settings → Usage 看用量。只要额度还有剩余、使用窗口没触顶,那就可以确定是服务端满载,接着看下一步。如果额度真的用完了,那是另一个问题,参考《Codex 怎么收费》。
第 2 步:升级到最新版,等它自动续跑
官方的修复一部分在服务端,一部分在客户端。先把 Codex 升到最新版:
npm install -g @openai/codex@latest
用 Homebrew 装的就 brew upgrade --cask codex,Codex App 按提示更新即可。升级后再遇到满载,通常稍等一会儿任务会自己接着跑,不需要你手动重发。
第 3 步:换一个模型
报错原文就写着「Please try a different model」——满载是按模型算的,换一个往往就好了。
在会话里输入 /model,从列表里选另一个模型;或者启动时直接指定:
codex -m 模型名
换模型只是临时绕开。等原模型恢复后,再用 /model 切回来就行。第 4 步:看一眼官方状态页
打开 status.openai.com,如果 Codex 相关服务标着故障或性能下降,那就是大范围的问题,本地怎么折腾都没用,等官方恢复就好。
第 5 步:在 config.toml 里调大重试次数
如果你用的是自定义 Provider,可以在 ~/.codex/config.toml 对应的 [model_providers.<id>] 下面调大重试次数,让 Codex 多扛几轮满载再报错:
[model_providers.aicodewith]
# 其他配置保持不变,只加下面三行
request_max_retries = 8          # 请求失败重试次数,默认 4
stream_max_retries = 10          # 流式中断重连次数,默认 5
stream_idle_timeout_ms = 300000  # 流式空闲超时,默认 300000(5 分钟)
这几个数字来自 Codex 源码:request_max_retries 默认 4、stream_max_retries 默认 5,两者上限都是 100,设得再大也会被截到 100。没必要拉满,翻一倍左右就够用。config.toml 各字段的完整说明见《Codex config.toml 配置指南》。
第 6 步:长任务改用 API Key 走 Provider
如果你经常跑长任务,被满载打断很心累,可以改用 API Key 通过 Provider 接入。把 Key 直接写进全局配置 ~/.codex/config.toml 即可,不用设置环境变量:
model_provider = "aicodewith"
model = "gpt-5.6-sol"

[model_providers.aicodewith]
name = "aicodewith"
base_url = "https://api.aicodewith.ai/chatgpt/v1"
wire_api = "responses"
experimental_bearer_token = "sk-你的Key"
注意:如果你之前的配置里有 env_key 这一行,记得删掉。留着它,Codex 会去读环境变量,找不到就报 Missing environment variable。更完整的接入步骤见《Codex 接入 AICodeWith》和《Codex API Key 怎么配置》。第 7 步:还是不行,用 /feedback 反馈
上面都试过还频繁报错,在 Codex 会话里输入 /feedback 提交反馈,官方能拿到对应的请求记录来排查。
Codex 常见报错对照表
| 报错 | 原因 | 先做什么 | 详细排查 |
|---|---|---|---|
| Selected model is at capacity(503) | 模型服务端满载 | 等自动续跑 / 换模型 / 调大重试 | 本文 |
| 429 Too Many Requests | 请求太快被限流 | 降频,按 Retry-After 等待 | Codex 429 怎么解决 |
| 额度用完(usage limit) | 套餐额度或使用窗口耗尽 | /status 看重置时间 | Codex 怎么收费 |
| 401 Unauthorized | 登录失效或 Key 不对 | 检查登录方式和 Key | Codex 401 怎么解决 |
| timeout 超时 | 网络、流式空闲等多种超时 | 先分清是哪种超时 | Codex timeout 怎么排查 |
常见问题
看到 at capacity,是我的额度用完了吗?
不是。额度用完是另一种报错(UsageLimitReached)。at capacity 是服务端满载,用 /status 确认额度还在就能排除。
Codex 一直重试、一直转圈正常吗?
正常。满载时 Codex 会按服务端给的等待时间自动重试,重试用完才报错。耐心等一会儿,或者直接换个模型。
Codex 503 和 429 有什么区别?
503 是服务器忙不过来,跟你发多快无关;429 是你(或你的账号)在短时间内请求太多,被限流了。前者换模型往往有效,后者要降低请求频率。
换了模型还是报 at capacity 怎么办?
先看 status.openai.com 有没有故障公告;没有的话升级到最新版,调大重试次数。长任务建议改用 API Key 走 Provider。
重试次数是不是越大越好?
不是。上限是 100,而且设太大时,真遇到长时间故障会一直卡着才报错。按默认值翻一倍左右就够了。