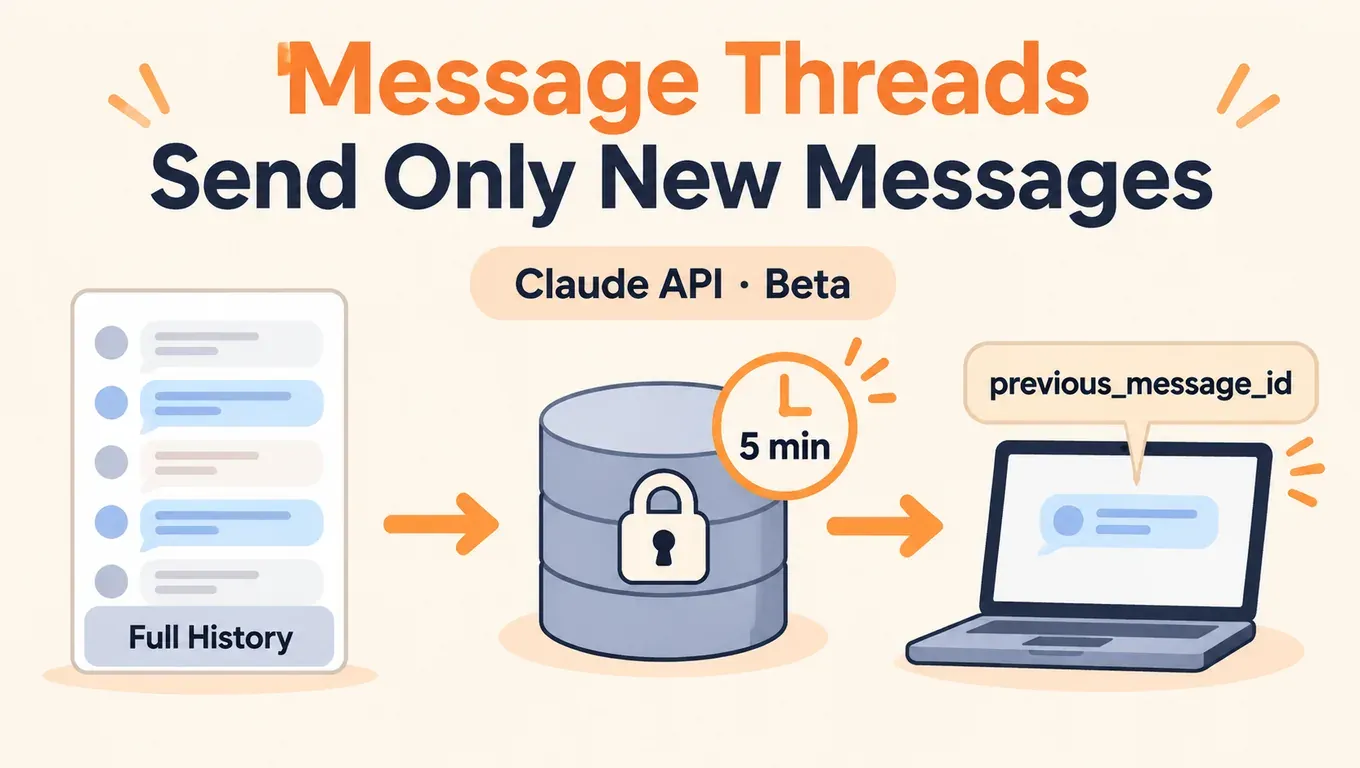
En resumen: con Message Threads, la Messages API guarda la conversación en el servidor durante un rato. A partir del segundo turno solo envías los mensajes nuevos y el id de la respuesta anterior, así que las peticiones son más pequeñas y Claude empieza a responder antes en conversaciones largas. Se ahorra latencia, no tokens.
- Según las notas de versión de Anthropic, los hilos de mensajes están en beta en la Messages API desde el 2 de noviembre. Las peticiones necesitan la cabecera beta
message-threads-2026-08-12y un parámetrothreaden el cuerpo. Un hilo caduca 5 minutos después de su última petición y se borra, como mucho, 1 hora después de su último uso. - Según el anuncio de Anthropic, los hilos ya vienen activados por defecto para la mayoría de usuarios de Claude Code, y en peticiones de 500.000 a 1 millón de tokens el tiempo mediano hasta el primer token baja alrededor de un 35 %. Claude sigue leyendo la conversación completa en cada turno, así que el uso de tokens no cambia, y tampoco la facturación ni los límites de velocidad.
- Lo probamos el 3 de noviembre con una clave de aicodewith: a través de aicodewith, el campo
threadse ignora por ahora. Todas las peticiones devuelven 200, pero el turno de continuación no tiene el contexto anterior y el modelo no recuerda lo que se dijo antes. Así que con aicodewith no uses hilos: envía el historial completo como siempre, con prompt caching. Claude Code no envía peticiones con hilos a aicodewith y funciona con normalidad.
Crear una API Key y conectar Claude en Claude Code, Codex o Cursor →
Qué son los Message Threads
La Messages API no recuerda las conversaciones. Sin hilo, un agente reenvía en cada turno todos los mensajes y resultados de herramientas anteriores, y la API vuelve a validarlos y tokenizarlos. Cuando la conversación llega a cientos de miles de tokens, solo eso ya retrasa el primer token.
Según la documentación oficial, un hilo funciona así: la primera petición se envía como siempre, con la conversación completa, system y tools, y se añade "thread": {"type": "create"}. La API guarda la conversación, incluida la respuesta de Claude, bajo el id de esa respuesta. En cada turno siguiente envías solo los mensajes posteriores a la respuesta anterior y añades "thread": {"type": "continue", "previous_message_id": "..."}; la API reconstruye la conversación completa antes de llamar al modelo. La respuesta es el message de siempre.
| Sin hilo | Con hilo | |
|---|---|---|
| Cuerpo de la petición por turno | Historial completo + system + tools | Completo en el turno 1; después solo mensajes nuevos + id de la respuesta anterior |
| Tiempo hasta el primer token | Crece con la conversación | Más bajo y estable, más cuanto más larga es la conversación |
| Uso de tokens | Se lee la conversación completa en cada turno | Igual, se sigue leyendo completa en cada turno |
| Facturación y límites de velocidad | Estándar | Sin cambios |
| Quién guarda la conversación | Tu aplicación | El servidor durante 5 minutos; tu aplicación sigue guardando una copia completa |
Además, según el resumen de @dotey, las cifras de Anthropic muestran que el tamaño mediano de petición en conversaciones largas baja de unos 800 KB a 1,8 KB. El anuncio de @ClaudeDevs sumaba unas 209.000 visualizaciones, 3.681 me gusta y 1.041 guardados la madrugada del 3 de noviembre (hora de Pekín) y entró en las tendencias de X.
Cómo usarlo: el parámetro thread y la cabecera beta
Cada petición de un hilo necesita anthropic-beta: message-threads-2026-08-12. Estos ejemplos apuntan a la API oficial de Anthropic (más abajo, el caso de aicodewith).
curl
# Turn 1: full conversation + system (+ tools), create a thread
curl -sS https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "anthropic-beta: message-threads-2026-08-12" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-opus-5-5",
    "max_tokens": 1024,
    "cache_control": {"type": "ephemeral"},
    "system": "You are a support agent for Acme. Keep replies short.",
    "messages": [{"role": "user", "content": "Hi! I have a question about an order."}],
    "thread": {"type": "create"}
  }'

# Turn 2: only the new message + the id of the turn 1 response
# (no system / tools here: the thread keeps them)
curl -sS https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "anthropic-beta: message-threads-2026-08-12" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-opus-5-5",
    "max_tokens": 1024,
    "cache_control": {"type": "ephemeral"},
    "messages": [{"role": "user", "content": "How long does standard shipping usually take?"}],
    "thread": {"type": "continue", "previous_message_id": "'"$MSG_ID"'"}
  }'
Guarda el id de la primera respuesta en MSG_ID y continúa desde él en el turno 2. Continúa siempre desde el id de respuesta más reciente; cada id solo se puede continuar una vez.
Python
El SDK oficial trae un asistente de hilos, client.beta.messages.thread(...). Añade la cabecera beta, quita system y tools de las peticiones continue y, ante un 404, reenvía una vez la conversación completa. También puedes pasar thread tú mismo a create:
import anthropic

client = anthropic.Anthropic()  # official API, reads ANTHROPIC_API_KEY

# Option A: the SDK thread helper (adds the beta header, replays on 404 for you)
thread = client.beta.messages.thread(
    model="claude-opus-5-5",
    max_tokens=1024,
    cache_control={"type": "ephemeral"},
    system="You are a support agent for Acme. Keep replies short.",
)
thread.send({"role": "user", "content": "Hi! I have a question about an order."})
second = thread.send({"role": "user", "content": "How long does standard shipping usually take?"})
print(second.content[-1].text)

# Option B: send the thread field yourself
first = client.beta.messages.create(
    model="claude-opus-5-5", max_tokens=1024,
    cache_control={"type": "ephemeral"},
    system="You are a support agent for Acme. Keep replies short.",
    messages=[{"role": "user", "content": "Hi! I have a question about an order."}],
    thread={"type": "create"},
    betas=["message-threads-2026-08-12"],
)
second = client.beta.messages.create(
    model="claude-opus-5-5", max_tokens=1024,
    cache_control={"type": "ephemeral"},
    messages=[{"role": "user", "content": "How long does standard shipping usually take?"}],
    thread={"type": "continue", "previous_message_id": first.id},
    betas=["message-threads-2026-08-12"],
)
TypeScript
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic(); // official API, reads ANTHROPIC_API_KEY

const thread = client.beta.messages.thread({
  model: "claude-opus-5-5",
  max_tokens: 1024,
  cache_control: { type: "ephemeral" },
  system: "You are a support agent for Acme. Keep replies short.",
});

await thread.send({ role: "user", content: "Hi! I have a question about an order." });
const second = await thread.send({
  role: "user",
  content: "How long does standard shipping usually take?",
});
for (const block of second.content) {
  if (block.type === "text") console.log(block.text);
}
Qué enviar en cada petición
La documentación oficial divide los campos en tres grupos:
| Grupo | Campos | Regla |
|---|---|---|
| Solo en create | system, tools | Enviarlos en una petición continue, aunque sea null, devuelve un 400 |
| Fijos | model, tool_choice, thinking, mcp_servers, context_management, output_config, el cache_control de nivel superior, el conjunto de valores de anthropic-beta, etc. | Enviarlos en cada petición con el mismo valor que en create; si no, 400 thread_fingerprint_mismatch |
| Cambiables en cada turno | max_tokens, stop_sequences, stream, metadata, etc. | Pueden cambiar de un turno a otro |
Para cambiar el prompt de sistema, las herramientas o el modelo, envía la conversación completa en una nueva petición create y empieza un hilo nuevo.
Caducidad y reenvío
Un hilo funciona en la medida de lo posible. Caduca 5 minutos después de su última petición; a partir de ahí, una petición continue devuelve un 404 con error.details.error_code igual a thread_not_found. Entonces envía la conversación completa desde tu propia copia en una nueva petición create y continúa desde el nuevo id. Por eso guarda siempre una copia local completa de la conversación y prepara el reenvío desde el principio. El asistente del SDK oficial reenvía una vez por ti.
¿Ahorra dinero? No, ahorra latencia
Según la documentación oficial, los hilos no cambian la facturación ni los límites de velocidad. Las peticiones son más pequeñas, pero Claude lee la conversación completa en cada turno, así que los tokens de entrada son los mismos que antes.
Para no volver a procesar los mismos tokens hace falta prompt caching. Un hilo no cachea por ti: los ejemplos oficiales envían un cache_control: {"type": "ephemeral"} de nivel superior en cada petición, de modo que cada turno lee la conversación anterior desde la caché y escribe el turno nuevo. Se complementan: el hilo reduce la subida y la caché reduce el reprocesado.
Según el anuncio de Anthropic, encaja sobre todo con agentes de programación de larga duración, agentes de computer use con una captura en cada turno y conversaciones con muchos documentos e imágenes. En chats cortos la ganancia es pequeña.
Qué cambia en Claude Code
Según el anuncio de Anthropic, los hilos ya vienen activados por defecto para la mayoría de usuarios de Claude Code; de ahí sale la cifra del 35 %. No hay que cambiar ningún ajuste.
Con un proxy local registramos las peticiones que envía Claude Code 2.1.316 cuando apunta a aicodewith con un ANTHROPIC_BASE_URL propio. Una tarea que leía dos archivos hizo 3 peticiones y ninguna llevaba campo thread ni message-threads-2026-08-12 en la cabecera beta. El número de mensajes pasó de 2 a 4 y a 6, cada petición llevaba el historial completo (unos 46 KB) y la tarea terminó con normalidad. Es decir, con una URL base de terceros Claude Code sigue funcionando como antes y los hilos no lo rompen.
Configuración:
export ANTHROPIC_BASE_URL="https://api.aicodewith.ai"
export ANTHROPIC_AUTH_TOKEN="TU_API_KEY"
claude --model claude-opus-5-5
Para dejar la configuración fija y para Windows, consulta Cómo conectar Claude Code a una API de terceros. Si quieres algo más de velocidad en sesiones largas, puedes bajar el effort: consulta Cómo elegir el effort de Claude Opus 5.5.
Message Threads es una función de la Messages API de Claude; Codex usa la API de OpenAI y no está implicado. El SDK de Codex también tiene «hilos», pero sirven para reanudar una sesión del lado del cliente, algo distinto de este almacenamiento en el servidor. Consulta Primeros pasos con el SDK de Codex: llamadas en TypeScript, eventos en streaming y reanudación de hilos.
¿Funciona a través de aicodewith? Resultados de la prueba
En la madrugada del 3 de noviembre de 2026 (hora de Pekín) llamamos al endpoint compatible con Anthropic de aicodewith, https://api.aicodewith.ai/v1/messages, con una clave de aicodewith, el modelo claude-opus-5-5 y la cabecera message-threads-2026-08-12, siguiendo los ejemplos oficiales caso por caso:
| Prueba | Esperado en la API oficial | Resultado real con aicodewith |
|---|---|---|
| create: conversación completa + thread: create | 200, hilo creado | 200, respuesta normal |
| continue: mensaje nuevo + id anterior | 200, el modelo ve los turnos anteriores | 200, pero input_tokens fue 27 y no había turnos anteriores |
| continuar el mismo id por segunda vez | 400 thread_already_continued | 200 |
| previous_message_id inexistente | 404 thread_not_found | 200 |
| continue con system | 400 | 200 |
| Asistente de hilos del SDK de Python 2.4.0 | El turno 2 recuerda el turno 1 | El turno 2 dijo que no tenía ningún número de pedido |
La respuesta real del turno de continuación (extracto):
Turn 1 (create):  "Hi! I have a question about an order."
  -> 200, "Happy to help. What's your order number, and what's the question about it?"
Turn 2 (continue, previous_message_id = turn 1 id):
  "How long does standard shipping usually take? Also, what did I say my question was about?"
  -> 200, input_tokens: 27
  -> "...As for your question, you didn't say what it was about beyond asking about standard shipping..."
Conclusión: aicodewith todavía no admite hilos de mensajes y trata el campo thread como si no existiera; cada petición se procesa de forma aislada. Lo delicado es que nada falla: el asistente del SDK nunca recibe un 404, nunca reenvía y la conversación pierde el contexto en silencio. Así que con aicodewith no añadas thread a las peticiones ni uses client.beta.messages.thread(...).
Alternativa: historial completo + prompt caching
Envía el historial completo en cada turno, como siempre, y añade un cache_control de nivel superior para activar la caché automática. Hicimos tres turnos con la misma clave de aicodewith (prompt de sistema de unos 7.500 tokens):
| Turno | Entrada (sin caché) | Escritura en caché | Lectura de caché | Tiempo | Respuesta |
|---|---|---|---|---|---|
| 1 | 24 | 7.568 | 0 | 4,0 s | Normal |
| 2 | 8 | 1.541 | 6.163 | 4,4 s | Normal |
| 3 | 8 | 1.560 | 6.240 | 3,5 s | «Your order number is A-1042.» |
Los turnos 2 y 3 acertaron en la caché y el turno 3 recordó bien el número de pedido del turno 1. En Python:
import anthropic

client = anthropic.Anthropic(
    base_url="https://api.aicodewith.ai",
    api_key="TU_API_KEY",
)

SYSTEM = "You are a support agent for Acme. Keep replies short.\n\n" + open("policy.md").read()
history = [{"role": "user", "content": "Hi! My order number is A-1042 and it hasn't shipped yet."}]

def turn(next_user_message=None):
    r = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        cache_control={"type": "ephemeral"},  # automatic caching: moves forward each turn
        system=SYSTEM,
        messages=history,                       # full history, no thread field
    )
    history.append({"role": "assistant", "content": [b.model_dump(exclude_none=True) for b in r.content]})
    if next_user_message:
        history.append({"role": "user", "content": next_user_message})
    u = r.usage
    print(u.input_tokens, u.cache_creation_input_tokens, u.cache_read_input_tokens)
    return r

turn("When will it ship?")
turn("What was my order number again?")
turn()
En TypeScript es la misma idea, con el historial completo en messages:
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic({
  baseURL: "https://api.aicodewith.ai",
  apiKey: "TU_API_KEY",
});

const history: Anthropic.MessageParam[] = [
  { role: "user", content: "Hi! My order number is A-1042 and it hasn't shipped yet." },
];

const r = await client.messages.create({
  model: "claude-opus-5-5",
  max_tokens: 1024,
  cache_control: { type: "ephemeral" },
  system: "You are a support agent for Acme. Keep replies short.",
  messages: history, // full history every turn, no thread field
});
history.push({ role: "assistant", content: r.content });
console.log(r.usage);
Cómo comprobar si un endpoint admite hilos de verdad
Envía una petición continue con un previous_message_id que no pueda existir. La API oficial devuelve 404 thread_not_found; un 200 con respuesta normal significa que el endpoint ignora thread:
# continue from an id that cannot exist
curl -sS https://api.aicodewith.ai/v1/messages \
  -H "x-api-key: TU_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "anthropic-beta: message-threads-2026-08-12" \
  -H "content-type: application/json" \
  -d '{"model":"claude-opus-5-5","max_tokens":200,"cache_control":{"type":"ephemeral"},
       "messages":[{"role":"user","content":"Hi"}],
       "thread":{"type":"continue","previous_message_id":"msg_doesnotexist123"}}'
# official API: 404, error.details.error_code = "thread_not_found"
# a gateway that ignores thread: 200 and a normal reply
Cuando aicodewith admita hilos, este comando lo mostrará sin tocar el código de tu aplicación.
Errores frecuentes
Según la documentación oficial, estos errores se devuelven antes de que el modelo se ejecute. No consumen tokens y el hilo y su caducidad no cambian.
404 thread_not_found
El hilo caducó (5 minutos sin peticiones), el turno anterior no se guardó, un modelo de respaldo escribió la respuesta anterior, la respuesta anterior aún se está generando, o la petición usa otra clave de API, organización o espacio de trabajo. Solución: enviar la conversación completa en una nueva petición create. Pedir un modelo que no existe también devuelve 404, así que revisa error.details.error_code antes de reenviar:
{
  "type": "error",
  "error": {
    "type": "not_found_error",
    "message": "...",
    "details": { "error_code": "thread_not_found" }
  },
  "request_id": "req_..."
}
400 thread_fingerprint_mismatch
Un campo fijo no coincide con la petición create: otro model u otro thinking, un cache_control de nivel superior distinto, o una cabecera beta de más o de menos. El mensaje de error indica los campos. Para cambiarlos, empieza un hilo nuevo.
400 thread_already_continued / thread_continue_in_flight
Cada id de respuesta solo se puede continuar una vez, o una petición continue anterior sigue en curso. Continúa siempre desde el id más reciente. Con streaming, espera al evento message_stop antes de continuar; hacerlo antes puede devolver un 404.
400 thread_unsupported_request
La petición usa algo que los hilos no admiten: más de 4 puntos de cache_control (el de nivel superior cuenta), compactación bajo demanda, la mayoría del context editing, o una organización con HIPAA o Inference hooks activados. Message Batches y el conteo de tokens tampoco aceptan thread. Quita esa función o envía la conversación completa sin thread.
Una petición continue incluye system o tools
Devuelve un 400 sin error_code. En continue envía solo los mensajes nuevos; el hilo guarda system y tools.
Con aicodewith el turno de continuación perdió el contexto
Ocurre porque aicodewith ignora thread por ahora, sin dar error. Quita thread y vuelve al historial completo + cache_control, como se explica arriba.
Conservación de datos y límites
- Según la documentación oficial, un hilo se guarda cifrado en memoria, nunca se escribe en almacenamiento persistente y se borra como mucho 1 hora después de su último uso. Los hilos no son aptos para retención cero de datos (ZDR) ni para HIPAA.
- No hay API para listar, leer o borrar un hilo.
- Disponible en la Claude API, Claude Platform on AWS, Claude Models on Google Cloud (Anthropic managed) y Claude in Microsoft Foundry, en beta en todos los modelos.
- Aparte, según la prensa, la marca de agua de texto de Claude cubre más modelos desde el 3 de noviembre; no tiene que ver con los hilos ni exige cambiar las peticiones. Consulta La marca de agua de Claude desde el 3 de noviembre.
Conclusión
Message Threads resuelve la latencia de reenviar todo el historial en cada turno: se crea un hilo en el primer turno y después solo se envían los mensajes nuevos y el id de la respuesta anterior. El primer token llega antes, el uso de tokens y la facturación no cambian, y conviene guardar una copia local completa para reenviar tras la caducidad de 5 minutos. Para agentes de larga duración conectados a la API oficial merece la pena activarlo. Con aicodewith, thread se ignora por ahora, así que envía el historial completo con cache_control; Claude Code con aicodewith no necesita cambios.
Crear una API Key y empezar en Claude Code, Codex o Cursor →