
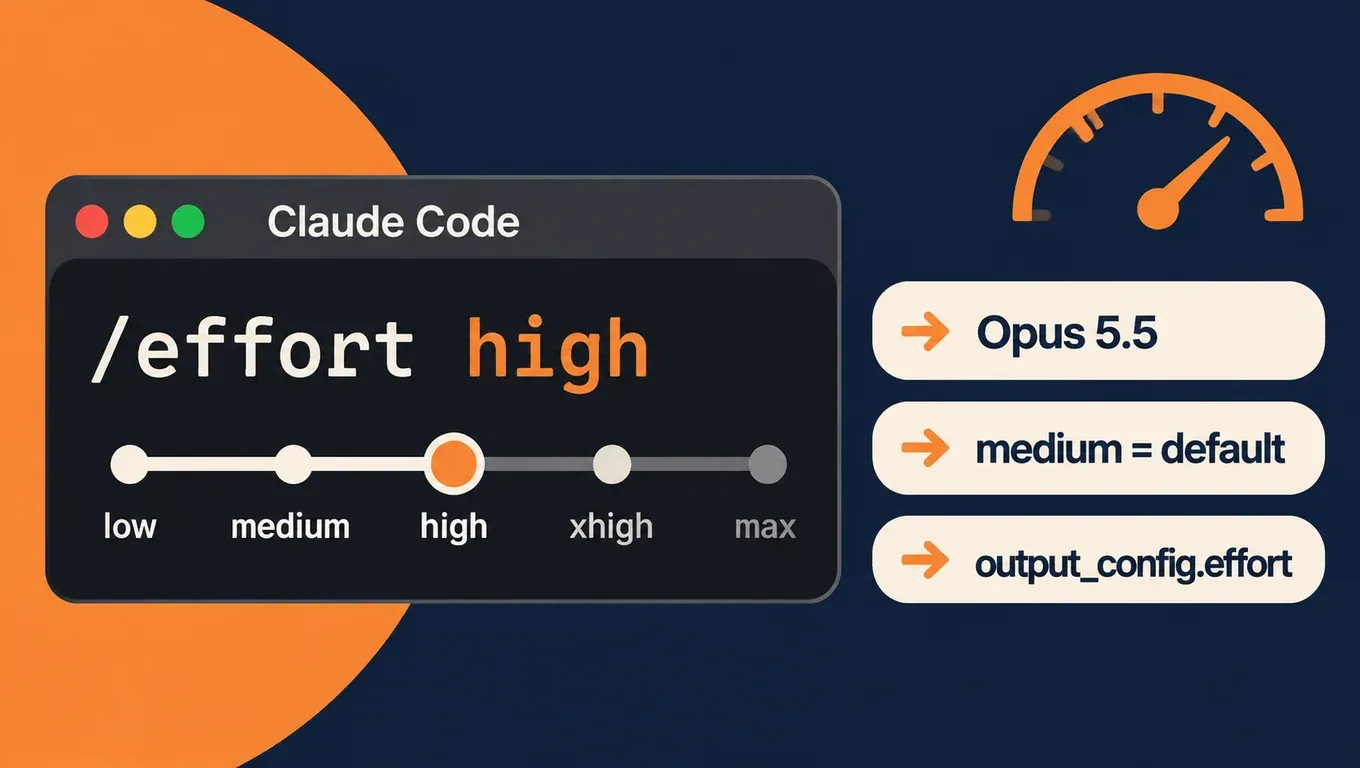
Resumen: el effort controla cuánto tiempo piensa Opus 5.5 y cuánto comprueba su propio trabajo. Hay cinco niveles, low, medium, high, xhigh y max, y el valor por defecto es medium, un nivel por debajo del high por defecto de Opus 5.
- Para el trabajo diario con un alcance claro, como implementar una funcionalidad, basta con
medium. Cambia ahighpara corregir bugs en un código existente y para tareas con muchos casos límite. Reservaxhighymaxpara tareas largas en las que el modelo debe verificar por su cuenta. Es la división que hace la documentación de Claude Code. - Según comentarios de usuarios, muchos que pasaron Opus 5.5 de
xhighahighobtienen resultados iguales o mejores. Artificial Analysis midió unos 100M de tokens de salida enxhighpara su batería completa frente a 56M enhigh: alrededor de 1,8 veces más tokens por 5 puntos más (57 frente a 52). - Una trampa en Claude Code: la antigua línea
"effortLevel": "high"en el nivel superior de~/.claude/settings.jsonno se aplica a Opus 5.5, que sigue enmedium. Ejecuta/effort highuna vez con Opus 5.5 y Claude Code lo guarda por modelo enmodelSettings. Lo comprobamos en nuestra propia prueba. - En la API, envía
"output_config": {"effort": "high"}. Si lo omites, se usamedium.
Crear API Key y usar Opus 5.5 en Claude Code, Codex o Cursor →
Qué significan los cinco niveles
El effort no es un tope estricto de tokens. Le indica al modelo cuánto trabajo merece la tarea, lo que afecta al tiempo que piensa, a la longitud de las respuestas y al número de llamadas a herramientas. La documentación oficial señala que en niveles bajos Claude sigue pensando ante problemas suficientemente difíciles, solo que menos. En Opus 5.5 el pensamiento adaptativo está siempre activo y no se puede desactivar, así que el effort es el control principal de la profundidad del razonamiento.
La tabla pone las recomendaciones de Anthropic junto a los resultados de Artificial Analysis en su Intelligence Index v5 para cada nivel (ver las páginas de comparación low / medium, high y xhigh / max):
| Nivel | Uso que sugiere Anthropic | Puntuación AA | Tokens de salida de la batería completa | Tiempo medio por tarea |
|---|---|---|---|---|
| low | Lluvia de ideas, primeros bocetos, cambios pequeños como un renombrado; subagentes | 35 | unos 21M | unos 153 s |
| medium (por defecto) | Trabajo diario con alcance claro, como una nueva funcionalidad | 48 | unos 43M | unos 347 s |
| high | Trabajo donde importa verificar o hay casos límite probables, como corregir un bug en código existente | 52 | unos 56M | unos 474 s |
| xhigh | Razonamiento más profundo; tareas de más de 30 minutos | 57 | unos 100M | unos 793 s |
| max | Problemas difíciles que Claude resuelve solo, como buscar vulnerabilidades; puede pensar de más | 58 | unos 218M | unos 1141 s |
Pasar de high a xhigh requiere unas 1,8 veces más tokens por 5 puntos. Pasar de xhigh a max vuelve a más que duplicar los tokens por 1 punto. AA también señala que medium, high, xhigh y max están en su frontera de Pareto de inteligencia frente a gasto por tarea: cada uno de esos cuatro niveles tiene sus casos de uso y ninguno es simplemente el mejor.
Por qué muchos están bajando el effort
La discusión arrancó el 31 de octubre. Según Theo (t3.gg), su compañero Julius lo convenció una o dos semanas antes de pasar Opus 5.5 de extra high a high, y le va «mejor casi siempre». Al día siguiente publicó un ranking de niveles de effort con high arriba, medium y xhigh después y max al final.
Otras reacciones habituales:
- Según @zwb44, que convirtió los datos de AA en un gráfico, «xhigh: 1,8 veces los tokens por 5 puntos más»; tras pasar a
highcomo nivel principal notó claramente la diferencia de uso y velocidad. - Según swyx, quien esté limitado por el rendimiento puede ir más lejos: effort
lowmás un bucle de autocrítica. - Según @jayleaton, usa
mediumel 95 % del tiempo y solo recurre ahighpara optimizaciones difíciles de kernels CUDA. - Otros opinan lo contrario: para programar solo sirven
highoxhigh, ylowse queda corto.
El resumen del tema en X también dice que «Anthropic recomienda high como el mejor equilibrio para la mayoría del trabajo». Revisamos la documentación oficial y no encontramos esa afirmación para Opus 5.5. Opus 5.5 parte de medium; la frase sobre high como mejor equilibrio entre calidad y eficiencia de tokens aparece en las recomendaciones para Opus 4.7. Este artículo sigue la documentación de Opus 5.5.
Qué dice Anthropic
- Empezar en medium y no heredar los ajustes de Opus 5: la guía de prompting de Opus 5.5 indica que, en las pruebas de Anthropic, Opus 5.5 en
mediumiguala o supera a Opus 5 enhighen evaluaciones de programación y trabajo intelectual, y que en varias evaluaciones de programaciónlowse acerca. Con el mismo nivel, Opus 5.5 piensa más por turno que Opus 5, sobre todo enxhighymax, así que mantener el ajuste antiguo implica turnos más largos y más tokens. - Usar
xhighymaxsolo si se mide una mejora: prueba varios niveles con tus propias tareas antes de decidir. Para que piense menos, baja primero el effort; funciona mejor que pedirlo en el prompt. - Cómo lo usa el autor del blog: en el blog oficial claude.dev, Thariq Shihipar explica en Spending your effort que, para una funcionalidad nueva, pide a Claude que lo entreviste sobre la especificación, implementa en
low, revisa el resultado y luego verifica y prueba enhigh. En sus pruebas, a mayor effort Claude probaba más casos límite y tomaba más decisiones por su cuenta;lowdevolvía antes un punto de partida, útil cuando acompañas cada paso.
Paso 1: crear una API Key y conectar Claude Code
- Regístrate en aicodewith.ai, abre la gestión de claves, crea una Key y copia la cadena completa que aparece al crearla.
- Define la URL y la Key en la terminal e inicia Claude Code con Opus 5.5:
export ANTHROPIC_BASE_URL="https://api.aicodewith.ai"
export ANTHROPIC_AUTH_TOKEN="TU_API_KEY"
claude --model claude-opus-5-5
Para dejarlo configurado de forma permanente, usar Windows o resolver conflictos de inicio de sesión, consulta Cómo conectar Claude Code a una API de terceros. Codex y Cursor también pueden usar modelos Claude; el mismo artículo lo explica.
Paso 2: configurar y cambiar el effort en Claude Code
La barra inferior de Claude Code muestra el nivel actual, por ejemplo ◐ medium · /effort. Los comandos que necesitas:
/effort status      # Effort level: auto (currently medium)
/effort high        # Set effort level to high (saved as your default for new sessions)
/effort             # interactive slider: low / medium / high / xhigh / max
/effort auto        # clear the saved level for the current model
- Un nivel escrito después de
/effort, o pulsar Enter en el control deslizante de/efforto en el selector de/model, se guarda como valor por defecto para ese modelo y se mantiene tras reiniciar. Pulsarsen el control deslizante lo aplica solo a la sesión actual. maxnunca se guarda; solo se aplica a la sesión actual, salvo que lo definas con la variable de entorno.- El nuevo nivel se aplica a partir de tu siguiente mensaje.
Para cambiar de forma temporal sin tocar el valor guardado:
# one session only
claude --model claude-opus-5-5 --effort high

# headless run (-p), this run only
claude -p "Fix the failing test" --model claude-opus-5-5 --effort low

# environment variable, overrides everything else
export CLAUDE_CODE_EFFORT_LEVEL=high
Claude Code elige el nivel en este orden: la variable de entorno CLAUDE_CODE_EFFORT_LEVEL, luego el nivel elegido en la sesión con /effort o /model, luego la opción --effort al arrancar, luego tus ajustes y por último el valor por defecto del modelo.
Trampa: la antigua clave effortLevel se ignora en Opus 5.5
Antes, /effort escribía una sola línea effortLevel en el nivel superior de ~/.claude/settings.json. Ahora Claude Code guarda el nivel por modelo. Después de /effort high, nuestro archivo quedó así:
{
  "modelSettings": {
    "claude-opus-5-5": {
      "effortLevel": "high"
    }
  }
}
Si tus ajustes de usuario aún usan la forma antigua:
{
  "effortLevel": "high"
}
En nuestra prueba, al iniciar Opus 5.5 con ese archivo, /effort status mostraba Effort level: auto (currently medium), es decir, el high antiguo se ignoraba. Al iniciar Opus 5 con el mismo archivo mostraba high. Coincide con la documentación: un effortLevel de nivel superior en los ajustes de usuario no cuenta para Opus 5.5 y modelos posteriores, mientras que uno en los ajustes de proyecto, locales o gestionados se aplica a todos los modelos. Después de pasar de Opus 5 a Opus 5.5, ejecuta /effort status para ver en qué nivel estás realmente.
También puedes definir effort en el frontmatter de un skill o de un subagente para darle su propio nivel. Para razonar más a fondo en un solo turno, escribe ultrathink en el prompt en lugar de cambiar el nivel de la sesión.
Paso 3: configurar el effort en una petición a la API
El effort va dentro de output_config y no necesita cabecera beta. Con nuestra Key, en curl:
curl https://api.aicodewith.ai/v1/messages \
  -H "x-api-key: TU_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-opus-5-5",
    "max_tokens": 32000,
    "output_config": { "effort": "high" },
    "messages": [{ "role": "user", "content": "Write parse_duration(s) ..." }]
  }'
SDK de Python:
import anthropic

client = anthropic.Anthropic(base_url="https://api.aicodewith.ai")
resp = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=32000,
    output_config={"effort": "high"},   # low / medium / high / xhigh / max
    messages=[{"role": "user", "content": "Write parse_duration(s) ..."}],
)
text = "".join(b.text for b in resp.content if b.type == "text")  # thinking block comes first
Puntos a tener en cuenta:
- Sin
output_config.effortse aplica el valor por defecto del modelo,mediumen Opus 5.5. Enviar"medium"explícitamente se comporta exactamente igual que omitirlo. - Cuanto más alto el nivel, mayor debe ser
max_tokens: el pensamiento cuenta dentro demax_tokens. Según Anthropic, 128000, el máximo de Opus 5.5, funciona bien para turnos largos de programación con agentes. - El primer bloque de
contentsuele serthinking. Lee la respuesta buscando los bloques contype == "text"en vez de tomar el primero. - Cambiar el effort de nivel superior a mitad de una conversación invalida la caché del prompt. Opus 5.5 admite cambiar el effort por mensaje (beta, cabecera
mid-conversation-output-config-2026-07-01), lo que conserva la caché; consulta la documentación oficial.
Prueba: todos los niveles con nuestra API Key
Prueba del 1 de noviembre de 2026 con claude-opus-5-5, todas las llamadas con nuestra Key.
API: una misma tarea en cada nivel
La tarea fue una función parse_duration(s) que convierte cadenas como "1h30m" o "2d4h" en segundos, gestionando mayúsculas, espacios, orden incorrecto, unidades repetidas, decimales, números negativos y otras entradas no válidas. Calificamos el código de cada nivel con 25 casos (10 válidos, 15 no válidos):
| effort | Tiempo | Tokens de salida | 25 casos |
|---|---|---|---|
| sin definir (por defecto) | unos 9,8 s | 411 | todos superados |
| low | unos 9,7 s | 410 | todos superados |
| medium | unos 10,7 s | 512 | todos superados |
| high | unos 12,1 s | 473 | todos superados |
| xhigh | unos 19,8 s | 798 | todos superados |
| max | unos 258,5 s | 5980 | todos superados |
Sin definir y low salieron casi iguales porque la tarea es fácil para Opus 5.5 y hasta el nivel por defecto piensa poco. En max, el modelo pensó más de cuatro minutos y generó más de diez veces los tokens de high, con el mismo 25/25. Nuestra petición max sin streaming se cortó tras algo más de cuatro minutos; con streaming ("stream": true) llegó el resultado, así que usa streaming en xhigh y max.
Claude Code: un bug corregido en cuatro niveles
Una función que fusiona rangos tenía un bug: los rangos que se tocan o son adyacentes no se fusionaban, y fallaban 2 de 6 pruebas:
# ranges.py
def merge_ranges(ranges):
    """Merge overlapping or touching [start, end] integer ranges."""
    ranges = sorted(ranges)
    out = []
    for s, e in ranges:
        if out and s < out[-1][1]:
            out[-1][1] = max(out[-1][1], e)
        else:
            out.append([s, e])
    return out
Ejecutamos Claude Code 2.1.310 en low, medium, high y xhigh:
claude -p "Fix merge_ranges in ranges.py so all tests in test_ranges.py pass, then run python3 -m unittest. Reply with one short summary line." \
  --model claude-opus-5-5 --effort high \
  --permission-mode acceptEdits --allowedTools "Bash(python3 -m unittest*)"
| effort | De Enter al resultado | Resultado |
|---|---|---|
| low | unos 8,8 s | las 6 pruebas pasan |
| medium | unos 10,2 s | las 6 pruebas pasan |
| high | unos 14,2 s | las 6 pruebas pasan |
| xhigh | unos 30,3 s | las 6 pruebas pasan |
Los cuatro niveles cambiaron la misma línea:
-        if out and s < out[-1][1]:
+        if out and s <= out[-1][1] + 1:
Encaja con lo que cuentan los usuarios: en una tarea pequeña, bien acotada y con pruebas, subir el nivel solo la hace más lenta, no mejor. La diferencia entre niveles aparece en tareas con muchos casos límite, sin pruebas previas o en las que el modelo debe verificar por su cuenta. Ahí es cuando conviene subir.
Crear API Key y probar tus propias tareas en varios niveles →
Qué nivel elegir
| Tarea | Nivel inicial | Notas |
|---|---|---|
| Preguntas, renombrados, borradores, subagentes | low | Rápido; revisas y guías cada paso |
| Funcionalidades bien acotadas, desarrollo diario | medium (por defecto) | Según Anthropic, equivale a Opus 5 en high |
| Corrección de bugs en código existente con pruebas | high | Según comentarios de usuarios, basta para la mayoría de quienes bajaron de xhigh |
| Tareas largas, migraciones, auditorías | xhigh | Muchos más tokens; max_tokens alto y streaming |
| Auditorías de seguridad y problemas difíciles que Claude resuelve solo | max | Anthropic advierte que puede pensar de más; pruébalo antes en algo pequeño |
Con una suscripción, los niveles altos consumen más tokens y agotan antes tu cupo. Con una API Key, el consumo de tokens sube con el nivel y puedes verlo por petición en tu historial de llamadas.
Errores y preguntas habituales
Error «Opus 5.5 effort 必须为 low、medium、high、xhigh 或 max»
Cuando enviamos "ultra" o "adaptive" como effort, nuestro endpoint respondió (el mensaje significa que el effort debe ser low, medium, high, xhigh o max):
HTTP 400
Opus 5.5 effort 必须为 low、medium、high、xhigh 或 max
Solo son válidos esos cinco nombres. adaptive es un modo de pensamiento, no un nivel de effort, y el ultracode de Claude Code tampoco es un nivel de la API; ninguno va en output_config.effort.
Puse high pero Opus 5.5 sigue en medium
Lo más probable es el problema de la clave antigua effortLevel descrito arriba. Ejecuta /effort high con Opus 5.5 y compruébalo con /effort status. Revisa también si está definida CLAUDE_CODE_EFFORT_LEVEL, porque tiene prioridad sobre todo lo demás.
thinking disabled o budget_tokens devuelve 400
Según la documentación de effort y la guía de migración de Opus 5.5, en Opus 5.5 el pensamiento está siempre activo, y la API oficial rechaza thinking: {"type": "disabled"} y budget_tokens. Elimina el campo thinking y controla la profundidad con el effort. Quita también temperature, top_p y top_k.
La respuesta se corta o solo trae pensamiento
max_tokens es demasiado pequeño y el pensamiento lo agotó. Sube max_tokens en niveles altos y usa streaming en tareas largas.
Elegir xhigh en Opus 4.6 o Sonnet 4.6
Esos dos modelos no tienen xhigh. Claude Code baja al nivel más alto disponible que no supere el elegido, así que en Opus 4.6 xhigh funciona como high.
¿El Fast mode es lo mismo que el effort?
No. El effort decide cuánto piensa y verifica el modelo; el Fast mode es un interruptor aparte. Para activarlo y saber cuándo ayuda, consulta Cómo usar el Fast Mode de Claude Opus 5.5.
¿Opus 5.5 en un nivel bajo o directamente Sonnet 5.5?
Los dos ahorran tiempo y tokens. Cuál conviene depende de la tarea, así que prueba tus propias tareas con ambos y compara. Para la comparación de modelos, consulta Claude Sonnet 5.5 vs Opus 5.5.
Lecturas relacionadas
- Cómo usar el Fast Mode de Claude Opus 5.5 en Claude Code
- Claude Sonnet 5.5 vs Opus 5.5 para programar
- Qué modelo usar en Claude Code: Opus 5.5 o Sonnet 5.5
- Cómo conectar Claude Code a una API de terceros: URL base, API Key y modelos
- Marca de agua de Claude desde el 3 de noviembre: ¿se marcan las salidas de Claude Code y la API?
Fuentes
- Documentación de Anthropic: Effort
- Documentación de Claude Code: Model configuration (Adjust effort level)
- Anthropic: Prompting Claude Opus 5.5 (Calibrate effort)
- Thariq Shihipar: Using Claude Code: Spending your effort
- Artificial Analysis: Claude Opus 5.5 takes the top spot, y las páginas de comparación xhigh vs max, high y medium vs low
- Publicaciones de Theo, el ranking de Theo, swyx, @zwb44 y @jayleaton
- El resumen del tema en X


