
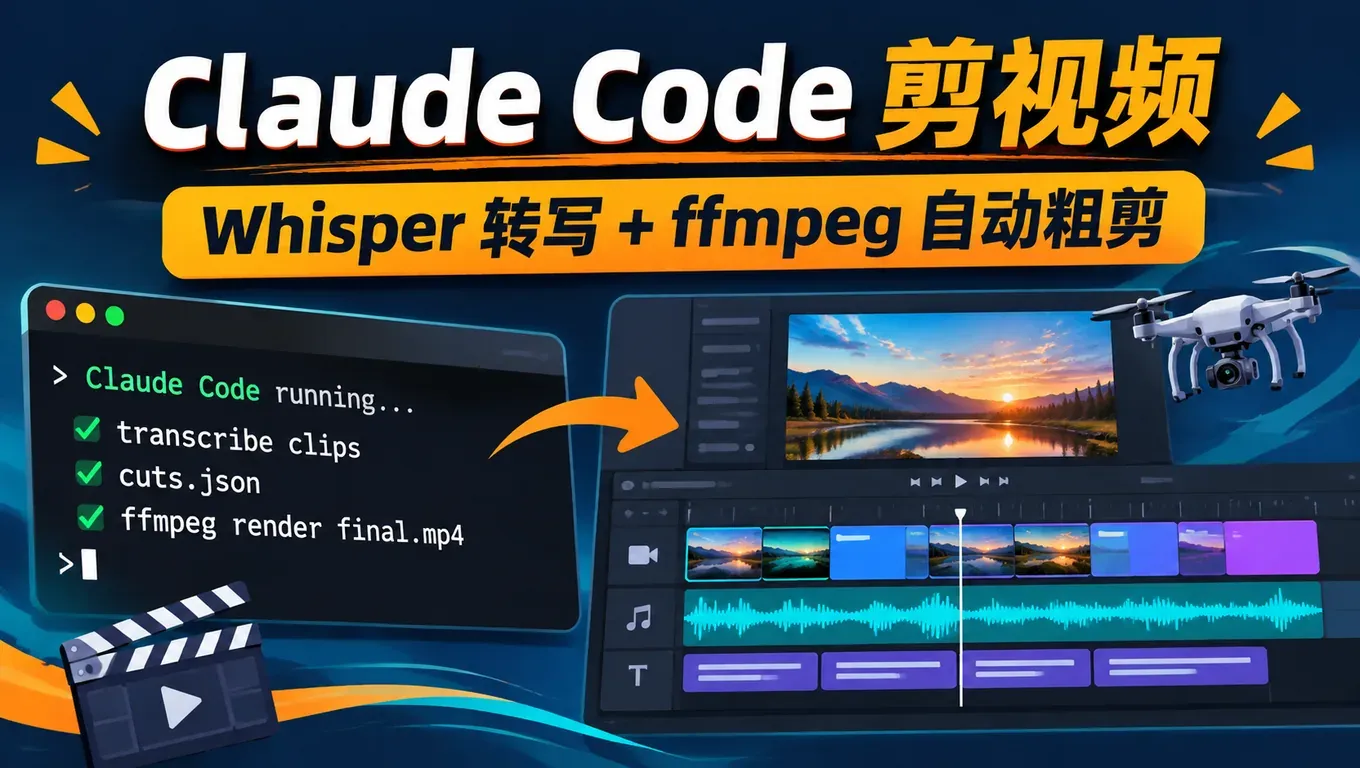
En resumen: Claude Code no puede «ver» el vídeo, pero sí puede ejecutar Whisper en tu equipo para convertir lo que se dice en cada clip en texto con marcas de tiempo, elegir la mejor toma a partir de ese texto, recortar los silencios del principio y el final y unirlo todo con ffmpeg, subtítulos incluidos. Eso es el corte en bruto, la parte más lenta de editar un vlog.
- La idea viene de levelsio. Según el post de levelsio del 1 de noviembre, copió los clips de su cámara DJI a una carpeta, abrió Claude Code (Opus 5.5) en ella y le pidió un vlog de 10 minutos. Dice que hizo «algunos ajustes, pero no muchos», y la transcripción se hizo con mlx-whisper. La tarde del 2 de noviembre (UTC+8) el post tenía unas 133.000 visualizaciones y más de 2.100 guardados.
- Lo reconstruimos con 6 clips de prueba, y tanto Claude Code como Codex llegaron al final: los dos descartaron el clip con la frase repetida desde cero y la toma duplicada peor, conservaron 4 clips, redujeron 53,8 segundos de material a unos 18 segundos y generaron subtítulos SRT y un script reutilizable
edit_vlog.py. - Dos advertencias: Whisper entendió mal un nombre de lugar (nuestro «洱海» (lago Erhai) salió como «海» (mar) y ninguno de los dos clientes lo notó), y Claude Code solo comprobó el audio y la duración, no la imagen. Lo dijo él mismo y recomendó ver el resultado antes de publicarlo.
Crear API Key y probar este flujo en Claude Code, Codex o Cursor →
Qué hizo levelsio
Según el post de levelsio, el flujo tiene tres pasos: copiar los clips de la cámara a una carpeta, abrir Claude Code en esa carpeta y pedirle que lo edite como «un vlog de 10 minutos». Claude Code primero transcribió todo lo que dijo con mlx-whisper y después decidió qué conservar y en qué orden.
En las respuestas, Sam Parr preguntó quién se encargó de las marcas de tiempo y de la foto superpuesta, lo que muestra la duda real: ¿hasta dónde llega la IA? Según la respuesta de levelsio a alguien que preguntaba si la edición ya estaba resuelta, las ediciones sencillas de vlog como esta ya funcionan y las más complejas tardarán alrededor de un año.
Coincide con nuestra prueba. Editar según lo que se dice (mejor toma, quitar repeticiones y pausas, ordenar, subtítulos) funciona bien hoy. Editar según lo que se ve (elegir planos, corrección de color, cortar al ritmo de la música) todavía necesita a una persona.
Cómo funciona el flujo
Claude Code y Codex son agentes de programación que trabajan en la terminal. No ven los fotogramas, pero escriben código y ejecutan comandos. Por eso la edición se divide en pasos que hacen bien:
| Paso | Herramienta | Resultado |
|---|---|---|
| 1. Transcribir | faster-whisper o mlx-whisper con marcas de tiempo por palabra | transcripts/<clip>.json con inicio y fin de cada palabra |
| 2. Seleccionar | El modelo lee las transcripciones y detecta repeticiones, muletillas y reinicios | Qué clips se quedan y por qué |
| 3. Recortar | Marcas de tiempo por palabra, comprobadas si hace falta con silencedetect de ffmpeg | Segundo de inicio y fin de cada clip |
| 4. Lista de edición | Un archivo JSON | cuts.json, editable a mano |
| 5. Render | trim y concat de ffmpeg | final.mp4 y subtitles.srt |
El paso 4 es el importante: las decisiones de edición están en un archivo JSON normal. Si un corte no te gusta, cambias un número y vuelves a renderizar, sin pedirle a la IA que empiece de cero.
Paso 1: crear una API Key y conectar Claude Code o Codex
- Regístrate en aicodewith.ai, inicia sesión, abre la página de claves API, crea una clave y copia la cadena completa que aparece al crearla.
- Claude Code: define la URL base y la clave, y arráncalo en la carpeta de los clips:
export ANTHROPIC_BASE_URL="https://api.aicodewith.ai"
export ANTHROPIC_AUTH_TOKEN="TU_API_KEY"
cd ~/Videos/2026-11-02      # the folder with your DJI_*.MP4 clips
claude --model claude-opus-5-5
Para guardar la configuración de forma permanente, configurarlo en Windows o resolver un conflicto de inicio de sesión, consulta Cómo conectar Claude Code a una API de terceros. Para elegir modelo, consulta Qué modelo usar en Claude Code.
- Codex: pon esto en
~/.codex/config.toml, con la clave enexperimental_bearer_token:
# ~/.codex/config.toml
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
model_provider = "aicodewith"

[model_providers.aicodewith]
name = "aicodewith"
base_url = "https://api.aicodewith.ai/chatgpt/v1"
wire_api = "responses"
experimental_bearer_token = "TU_API_KEY"
La instalación completa de Codex está en la guía de instalación de Codex.
Paso 2: instalar las herramientas de transcripción y edición
El agente escribe sus propios scripts, pero instala Whisper y ffmpeg antes para que no se detenga a mitad de camino a instalarlos pidiéndote que apruebes cada paso:
# Windows / Linux / Intel Mac
pip install faster-whisper
# Apple Silicon Mac (what levelsio used)
pip install mlx-whisper
# ffmpeg: brew install ffmpeg / sudo apt install ffmpeg / winget install ffmpeg
ffmpeg -version
mlx-whisper solo funciona en Mac con Apple Silicon (whisper en mlx-examples). En Windows, Linux y Mac con Intel usa faster-whisper; es el que usamos en la prueba, y el modelo small se descarga solo la primera vez.
Paso 3: darle el prompt al agente
Pon los clips originales en clips/ dentro de la carpeta del proyecto y dale a Claude Code o Codex el siguiente prompt. Es el texto exacto de nuestra prueba. Nuestro material estaba en chino, por eso language zh; para material en español usa es:
The clips/ folder has raw vlog clips straight off my camera (DJI_*.MP4, Chinese speech). Edit them into one short vlog:
1. Transcribe every clip with faster-whisper (model "small", language zh, word timestamps) and save the transcripts to transcripts/<clip>.json.
2. Pick the best takes: when I repeat a sentence keep only the better, more complete take, and drop clips that are only filler or me restarting. Trim the leading and trailing silence of each kept clip.
3. Write the edit decision list to cuts.json as [{"clip": ..., "start": seconds, "end": seconds, "reason": ...}] in playback order.
4. Render final.mp4 (1280x720, 30fps, H.264 + AAC) from cuts.json with ffmpeg, and write subtitles.srt with the kept speech, timed to final.mp4.
5. Verify with ffprobe that final.mp4 plays end to end, then reply with a short summary: which clips you kept or dropped and why, and the final duration.
Write the pipeline as a reusable script edit_vlog.py so I can rerun it on tomorrow's clips.
Tres cosas del prompt importan. Las marcas de tiempo por palabra permiten recortar al nivel de palabra. cuts.json hace que las decisiones de edición se puedan revisar y cambiar. Un script reutilizable convierte los clips de mañana en una nueva ejecución, no en otra conversación.
Para ejecutarlo en segundo plano sin confirmar cada paso, usa el modo no interactivo. En Claude Code, --allowedTools deja pasar solo los comandos de Python y ffmpeg, algo más seguro que saltarse todas las confirmaciones de permisos:
# Claude Code, non-interactive
claude -p "$(cat prompt.txt)" --model claude-opus-5-5 \
  --permission-mode acceptEdits \
  --allowedTools "Bash(python3:*)" "Bash(ffmpeg:*)" "Bash(ffprobe:*)" "Bash(ls:*)" "Bash(mkdir:*)"

# Codex, non-interactive
codex exec --skip-git-repo-check --sandbox danger-full-access "$(cat prompt.txt)"
En Codex usamos --sandbox danger-full-access porque faster-whisper descarga su modelo la primera vez y el sandbox por defecto bloquea la red. Es mucho acceso, así que úsalo solo en una carpeta dedicada a tus clips. Para los permisos de automatización de Codex, consulta la guía de permisos de automatización de Codex.
Prueba: Claude Code y Codex con una clave de aicodewith
Preparamos 6 clips de prueba en 720p, de 8 a 11 segundos cada uno, con al menos 2 segundos de silencio al principio y al final. El audio es la narración de un vlog grabado en Dali, con dos problemas habituales puestos a propósito:
DJI_0002solo contiene «eh, este, mmm, espera, lo vuelvo a decir», un reinicio.DJI_0003yDJI_0004son dos tomas de la misma frase. La segunda es más completa (añade «y el wifi va rápido») pero tiene un «mmm» en medio.
Los dos clientes recibieron el mismo prompt en la misma máquina Linux:
| Claude Code 2.1.316 + Opus 5.5 | Codex 0.164.0 + GPT-6.1 Sol | |
|---|---|---|
| Tiempo | Unos 287 segundos, 25 turnos | Unos 93 segundos |
| Conservados | 0001, 0004, 0005, 0006 | 0001, 0004, 0005, 0006 |
| Descartados | 0002 (reinicio), 0003 (toma duplicada incompleta) | Igual |
| Vídeo final | 18,13 s, 1280×720, 30 fps, H.264 + AAC | 18,2 s, mismas características |
| Subtítulos | 4 entradas, una por clip | 6 entradas, divididas en las pausas |
| Autocomprobación | ffprobe, decodificación completa, puntos de corte comprobados con silencedetect | ffprobe y decodificación completa |
Los dos hicieron exactamente la misma selección. Claude Code fue más lento y dedicó ese tiempo a revisarse: comprobó cada punto de corte con la detección de silencios de ffmpeg y esquivó un error de la biblioteca de transcripción (ver abajo). Su cuts.json quedó así:
[
  {"clip": "DJI_0001.MP4", "start": 1.99, "end": 5.98, "reason": "大家好,今天我在大理,早上先去海边走一走。"},
  {"clip": "DJI_0004.MP4", "start": 1.83, "end": 8.66, "reason": "best of 2 takes (DJI_0003.MP4, DJI_0004.MP4)"},
  {"clip": "DJI_0005.MP4", "start": 1.87, "end": 5.96, "reason": "下午我们开车去苍山,路上风景特别好。"},
  {"clip": "DJI_0006.MP4", "start": 2.17, "end": 5.34, "reason": "好了,今天的视频就到这里,我们明天见!"}
]
El edit_vlog.py generado puede repetir etapas sueltas, así que tras editar cuts.json solo hay que volver a renderizar:
python3 edit_vlog.py                  # full pipeline, reuses cached transcripts
python3 edit_vlog.py --stage select   # only rebuild cuts.json and print keep/drop reasons
python3 edit_vlog.py --stage render   # re-render after you hand-edit cuts.json
Tres problemas que destapó la prueba
- Un nombre de lugar mal transcrito. En las dos transcripciones, «早上先去洱海边走一走» (un paseo matinal junto al lago Erhai) se convirtió en «早上先去海边走一走» (un paseo junto al mar). Los subtítulos también salieron mal y ningún cliente lo notó. A Whisper le pasa mucho con los nombres propios, así que lee siempre los subtítulos antes de publicar.
- El «mmm» a mitad de frase se quedó. Whisper simplemente omitió el «mmm» del clip 0004 en la transcripción, así que la IA no supo que debía cortarlo y todavía se oye en el vídeo final. Para quitar muletillas dentro de una frase, pide en el prompt cortes en las marcas de tiempo de las palabras y acepta saltos en la imagen.
- El agente escucha pero no mira. Claude Code dijo claramente que solo comprobó el audio, los tiempos y el archivo, no la imagen. Un plano desenfocado, la tapa del objetivo puesta o algo en cuadro que no querías enseñar: no se va a enterar.
Problemas y errores frecuentes
faster-whisper falla con un error de PyAV al leer el audio
Claude Code se lo encontró en la prueba: la versión de PyAV instalada no funcionaba con el cargador de audio de faster-whisper 1.2.1. Lo esquivó decodificando a mono de 16 kHz con ffmpeg y pasándoselo al modelo, y a partir de ahí todo funcionó:
# decode with ffmpeg instead of faster-whisper's built-in PyAV loader
import subprocess, numpy as np
def load_audio(path, sr=16000):
    raw = subprocess.run(["ffmpeg", "-v", "error", "-i", str(path), "-vn", "-ac", "1",
                          "-ar", str(sr), "-f", "f32le", "-"],
                         check=True, capture_output=True).stdout
    return np.frombuffer(raw, dtype=np.float32).copy()

segs, info = model.transcribe(load_audio(clip), language="zh", word_timestamps=True)
Nombres de lugares, personas o marcas mal transcritos
Pasa en initial_prompt una frase completa que contenga la palabra y añade hotwords. En nuestra prueba, una lista de palabras como initial_prompt="洱海 苍山 大理 手冲" no sirvió, y hotwords="洱海" solo tampoco. Con las dos cosas juntas y el prompt escrito como frase, «洱海» salió bien:
segs, info = model.transcribe(audio, language="zh",
                              initial_prompt="今天去洱海边散步。",   # a sentence that contains the word
                              hotwords="洱海")
Los subtítulos no van sincronizados con la imagen
Pide al agente que recalcule los tiempos de los subtítulos a partir del inicio de cada clip en cuts.json, en vez de reutilizar las marcas de tiempo de los clips originales. En nuestra prueba, los subtítulos de los dos clientes empezaban en el segundo 0 del vídeo final. La primera entrada era así:
1
00:00:00,150 --> 00:00:03,690
大家好,今天我在大理,早上先去海边走一走。
El material largo tarda demasiado en transcribirse
Empieza con el modelo small, confirma que el flujo funciona y luego pasa a uno más grande. Las transcripciones se guardan en transcripts/, así que cambiar la lista de edición no vuelve a transcribir. El nivel de effort de Opus 5.5 también influye en el tiempo; elegir tomas es una tarea bien acotada y basta con el nivel por defecto. Consulta Cómo elegir los niveles de effort de Claude Opus 5.5.
Quieres que edite cada día
Convierte el prompt y edit_vlog.py en una Skill para que «edita el vlog de hoy» la active. Consulta Cómo escribir un SKILL.md.
Resumen
Editar vídeo con Claude Code o Codex funciona hoy para un corte en bruto basado en lo que se dice: transcribir, elegir la mejor toma, quitar reinicios y silencios, renderizar y subtitular. En pocos minutos una carpeta de clips se convierte en un primer montaje que se puede ver. Los nombres propios de los subtítulos, la calidad de imagen, el ritmo y la música siguen necesitando tu propia revisión.


