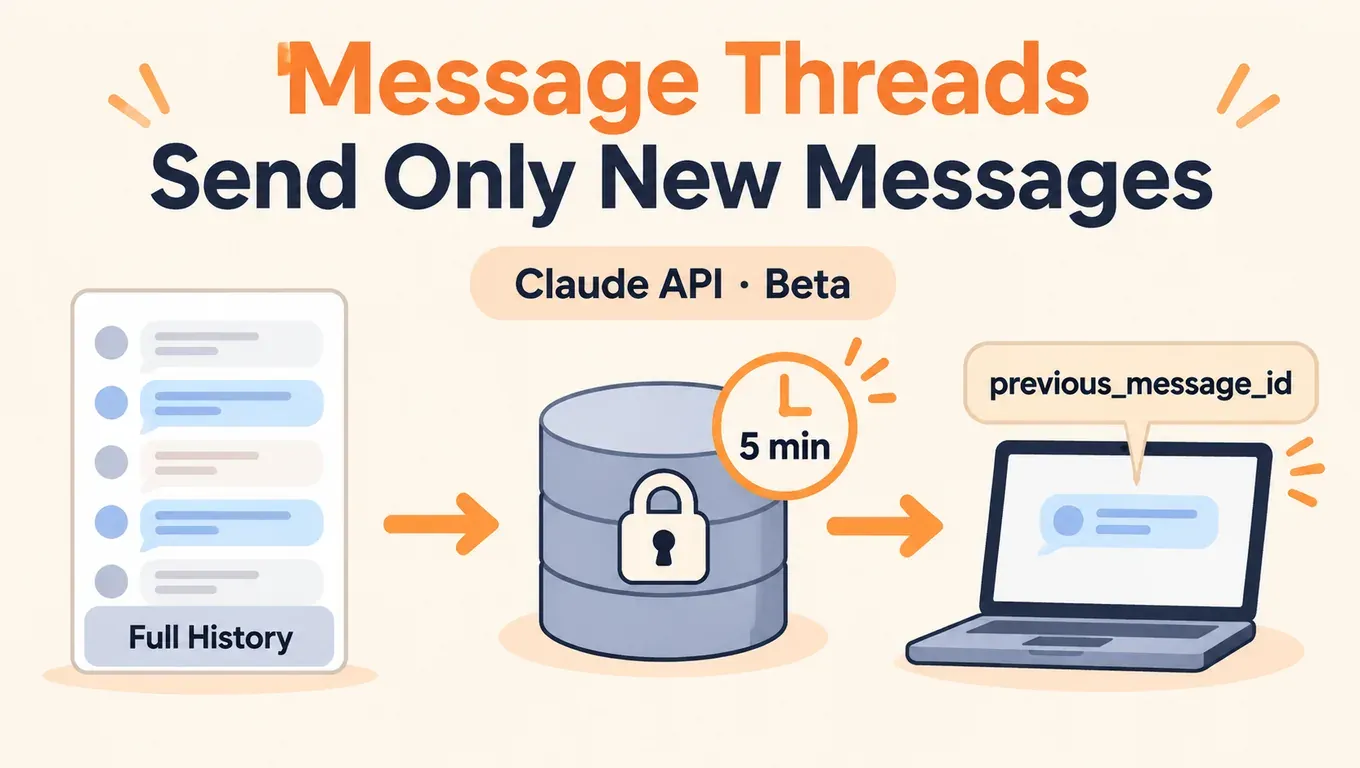
En bref : les Message Threads permettent à l'API Messages de garder une conversation côté serveur pendant un court moment. Après le premier tour, vous n'envoyez que les nouveaux messages et l'id de la réponse précédente : les requêtes sont plus petites et Claude commence à répondre plus tôt dans les longues conversations. On gagne en latence, pas en tokens.
- Selon les notes de version d'Anthropic, les threads de messages sont en bêta sur l'API Messages depuis le 2 novembre. Les requêtes doivent porter l'en-tête bêta
message-threads-2026-08-12et un paramètrethreaddans le corps. Un thread expire 5 minutes après sa dernière requête et il est supprimé au plus tard 1 heure après sa dernière utilisation. - Selon l'annonce d'Anthropic, les threads sont déjà activés par défaut pour la plupart des utilisateurs de Claude Code, et pour les requêtes de 500 000 à 1 million de tokens, le délai médian avant le premier token baisse d'environ 35 %. Claude relit toujours toute la conversation à chaque tour : la consommation de tokens ne change pas, pas plus que la facturation et les limites de débit.
- Nous avons testé le 3 novembre avec une clé aicodewith : via aicodewith, le champ
threadest actuellement ignoré. Toutes les requêtes renvoient 200, mais le tour de continuation n'a pas le contexte précédent et le modèle ne retrouve pas ce qui a été dit. Via aicodewith, n'utilisez donc pas les threads : envoyez l'historique complet comme d'habitude, avec le prompt caching. Claude Code n'envoie pas de requêtes thread vers aicodewith et fonctionne normalement.
Créer une API Key et connecter Claude dans Claude Code, Codex ou Cursor →
Que sont les Message Threads
L'API Messages ne mémorise pas les conversations. Sans thread, un agent renvoie à chaque tour tous les messages et résultats d'outils précédents, et l'API les valide et les tokenise de nouveau. Quand la conversation atteint des centaines de milliers de tokens, cette étape suffit à retarder le premier token.
Selon la documentation officielle, un thread fonctionne ainsi : la première requête part comme d'habitude, avec toute la conversation, system et tools, plus "thread": {"type": "create"}. L'API enregistre la conversation, réponse de Claude comprise, sous l'id de la réponse. À chaque tour suivant, vous n'envoyez que les messages postérieurs à la réponse précédente, plus "thread": {"type": "continue", "previous_message_id": "..."}, et l'API reconstitue la conversation complète avant d'appeler le modèle. La réponse est un message habituel.
| Sans thread | Avec thread | |
|---|---|---|
| Corps de requête à chaque tour | Historique complet + system + tools | Complet au tour 1 ; ensuite seulement les nouveaux messages + id de la réponse précédente |
| Délai avant le premier token | Augmente avec la conversation | Plus bas et plus stable, surtout quand la conversation s'allonge |
| Consommation de tokens | Conversation complète lue à chaque tour | Identique, la conversation complète est toujours lue |
| Facturation et limites de débit | Standard | Inchangées |
| Qui garde la conversation | Votre application | Le serveur pendant 5 minutes ; votre application garde quand même une copie complète |
Par ailleurs, selon le résumé de @dotey, les chiffres d'Anthropic montrent une taille médiane de requête qui passe d'environ 800 Ko à 1,8 Ko dans les longues conversations. L'annonce de @ClaudeDevs comptait environ 209 000 vues, 3 681 j'aime et 1 041 signets le matin du 3 novembre (heure de Pékin) et figurait dans les tendances X.
Utilisation : le paramètre thread et l'en-tête bêta
Chaque requête d'un thread doit porter anthropic-beta: message-threads-2026-08-12. Les exemples ci-dessous visent l'API officielle d'Anthropic (voir plus bas pour aicodewith).
curl
# Turn 1: full conversation + system (+ tools), create a thread
curl -sS https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "anthropic-beta: message-threads-2026-08-12" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-opus-5-5",
    "max_tokens": 1024,
    "cache_control": {"type": "ephemeral"},
    "system": "You are a support agent for Acme. Keep replies short.",
    "messages": [{"role": "user", "content": "Hi! I have a question about an order."}],
    "thread": {"type": "create"}
  }'

# Turn 2: only the new message + the id of the turn 1 response
# (no system / tools here: the thread keeps them)
curl -sS https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "anthropic-beta: message-threads-2026-08-12" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-opus-5-5",
    "max_tokens": 1024,
    "cache_control": {"type": "ephemeral"},
    "messages": [{"role": "user", "content": "How long does standard shipping usually take?"}],
    "thread": {"type": "continue", "previous_message_id": "'"$MSG_ID"'"}
  }'
Enregistrez l'id de la première réponse dans MSG_ID et continuez à partir de lui au tour 2. Continuez toujours depuis le dernier id de réponse ; chaque id ne peut être continué qu'une fois.
Python
Le SDK officiel propose un assistant de thread, client.beta.messages.thread(...). Il ajoute l'en-tête bêta, retire system et tools des requêtes continue et renvoie une fois la conversation complète en cas de 404. Vous pouvez aussi passer thread vous-même à create :
import anthropic

client = anthropic.Anthropic()  # official API, reads ANTHROPIC_API_KEY

# Option A: the SDK thread helper (adds the beta header, replays on 404 for you)
thread = client.beta.messages.thread(
    model="claude-opus-5-5",
    max_tokens=1024,
    cache_control={"type": "ephemeral"},
    system="You are a support agent for Acme. Keep replies short.",
)
thread.send({"role": "user", "content": "Hi! I have a question about an order."})
second = thread.send({"role": "user", "content": "How long does standard shipping usually take?"})
print(second.content[-1].text)

# Option B: send the thread field yourself
first = client.beta.messages.create(
    model="claude-opus-5-5", max_tokens=1024,
    cache_control={"type": "ephemeral"},
    system="You are a support agent for Acme. Keep replies short.",
    messages=[{"role": "user", "content": "Hi! I have a question about an order."}],
    thread={"type": "create"},
    betas=["message-threads-2026-08-12"],
)
second = client.beta.messages.create(
    model="claude-opus-5-5", max_tokens=1024,
    cache_control={"type": "ephemeral"},
    messages=[{"role": "user", "content": "How long does standard shipping usually take?"}],
    thread={"type": "continue", "previous_message_id": first.id},
    betas=["message-threads-2026-08-12"],
)
TypeScript
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic(); // official API, reads ANTHROPIC_API_KEY

const thread = client.beta.messages.thread({
  model: "claude-opus-5-5",
  max_tokens: 1024,
  cache_control: { type: "ephemeral" },
  system: "You are a support agent for Acme. Keep replies short.",
});

await thread.send({ role: "user", content: "Hi! I have a question about an order." });
const second = await thread.send({
  role: "user",
  content: "How long does standard shipping usually take?",
});
for (const block of second.content) {
  if (block.type === "text") console.log(block.text);
}
Que mettre dans chaque requête
La documentation officielle classe les champs en trois groupes :
| Groupe | Champs | Règle |
|---|---|---|
| Seulement à la création | system, tools | Les envoyer dans une requête continue, même à null, renvoie une 400 |
| Fixes | model, tool_choice, thinking, mcp_servers, context_management, output_config, cache_control de premier niveau, l'ensemble des valeurs anthropic-beta, etc. | À envoyer à chaque requête avec la même valeur qu'à la création, sinon 400 thread_fingerprint_mismatch |
| Modifiables à chaque tour | max_tokens, stop_sequences, stream, metadata, etc. | Modifiables d'un tour à l'autre |
Pour changer le prompt système, les outils ou le modèle, envoyez la conversation complète dans une nouvelle requête create et démarrez un nouveau thread.
Expiration et relance
Un thread est fourni au mieux. Il expire 5 minutes après sa dernière requête ; ensuite, une requête continue renvoie une 404 avec error.details.error_code égal à thread_not_found. Renvoyez alors la conversation complète depuis votre propre copie dans une nouvelle requête create, puis continuez depuis le nouvel id. Gardez donc toujours une copie locale complète de la conversation et prévoyez la relance dès le départ. L'assistant du SDK officiel relance une fois pour vous.
Est-ce que ça fait économiser ? Non, ça réduit la latence
Selon la documentation officielle, les threads ne changent ni la facturation ni les limites de débit. Les requêtes sont plus petites, mais Claude relit toute la conversation à chaque tour : les tokens d'entrée restent les mêmes.
Pour éviter de retraiter les mêmes tokens, il faut le prompt caching. Un thread ne met rien en cache à votre place : les exemples officiels envoient un cache_control: {"type": "ephemeral"} de premier niveau à chaque requête, si bien que chaque tour lit la conversation précédente depuis le cache et y écrit le nouveau tour. Les deux se complètent : le thread réduit l'envoi, le cache réduit le retraitement.
Cas adaptés, selon l'annonce d'Anthropic : agents de code de longue durée, agents de computer use avec une capture d'écran à chaque tour, conversations chargées en documents et en images. Pour une courte discussion, le gain est faible.
Ce qui change dans Claude Code
Selon l'annonce d'Anthropic, les threads sont déjà activés par défaut pour la plupart des utilisateurs de Claude Code ; c'est de là que vient le chiffre de 35 %. Aucun réglage n'est à modifier.
Avec un proxy local, nous avons enregistré les requêtes envoyées par Claude Code 2.1.316 pointé vers aicodewith via un ANTHROPIC_BASE_URL personnalisé. Une tâche qui lisait deux fichiers a fait 3 requêtes, et aucune ne contenait de champ thread ni message-threads-2026-08-12 dans l'en-tête bêta. Le nombre de messages est passé de 2 à 4 puis 6, chaque requête portait l'historique complet (environ 46 Ko) et la tâche s'est terminée normalement. Autrement dit, avec une URL de base tierce, Claude Code fonctionne comme avant et n'est pas cassé par les threads.
Configuration :
export ANTHROPIC_BASE_URL="https://api.aicodewith.ai"
export ANTHROPIC_AUTH_TOKEN="VOTRE_API_KEY"
claude --model claude-opus-5-5
Pour une configuration durable et Windows, voir Connecter Claude Code à une API tierce. Pour gagner un peu de vitesse dans les longues sessions, vous pouvez baisser l'effort : voir Choisir l'effort de Claude Opus 5.5.
Les Message Threads sont une fonction de l'API Messages de Claude ; Codex passe par l'API d'OpenAI et n'est pas concerné. Le SDK Codex a lui aussi des « threads », mais ils reprennent une session côté client, ce qui n'a rien à voir avec ce stockage côté serveur. Voir Débuter avec le SDK Codex : appels TypeScript, événements en streaming et reprise de thread.
Est-ce que ça marche via aicodewith ? Résultats du test
Tôt le 3 novembre 2026 (heure de Pékin), nous avons appelé l'endpoint compatible Anthropic d'aicodewith, https://api.aicodewith.ai/v1/messages, avec une clé aicodewith, le modèle claude-opus-5-5 et l'en-tête message-threads-2026-08-12, en suivant les exemples officiels un par un :
| Test | Attendu sur l'API officielle | Constaté via aicodewith |
|---|---|---|
| create : conversation complète + thread: create | 200, thread créé | 200, réponse normale |
| continue : nouveau message + id précédent | 200, le modèle voit les tours précédents | 200, mais input_tokens à 27 et aucun tour précédent visible |
| continuer deux fois le même id | 400 thread_already_continued | 200 |
| previous_message_id inexistant | 404 thread_not_found | 200 |
| continue avec system | 400 | 200 |
| Assistant de thread du SDK Python 2.4.0 | Le tour 2 se souvient du tour 1 | Le tour 2 répond qu'il n'a aucun numéro de commande |
La vraie réponse au tour de continuation (extrait) :
Turn 1 (create):  "Hi! I have a question about an order."
  -> 200, "Happy to help. What's your order number, and what's the question about it?"
Turn 2 (continue, previous_message_id = turn 1 id):
  "How long does standard shipping usually take? Also, what did I say my question was about?"
  -> 200, input_tokens: 27
  -> "...As for your question, you didn't say what it was about beyond asking about standard shipping..."
Conclusion : aicodewith ne prend pas encore en charge les threads de messages et traite le champ thread comme s'il n'existait pas ; chaque requête est traitée isolément. Le piège, c'est que rien n'échoue : l'assistant du SDK ne reçoit jamais de 404, ne relance jamais, et la conversation perd son contexte sans bruit. Via aicodewith, n'ajoutez donc pas thread aux requêtes et n'utilisez pas client.beta.messages.thread(...).
Solution de rechange : historique complet + prompt caching
Envoyez l'historique complet à chaque tour, comme d'habitude, et ajoutez un cache_control de premier niveau pour activer le cache automatique. Nous avons fait trois tours avec la même clé aicodewith (prompt système d'environ 7 500 tokens) :
| Tour | Entrée (hors cache) | Écriture cache | Lecture cache | Durée | Réponse |
|---|---|---|---|---|---|
| 1 | 24 | 7 568 | 0 | 4,0 s | Normale |
| 2 | 8 | 1 541 | 6 163 | 4,4 s | Normale |
| 3 | 8 | 1 560 | 6 240 | 3,5 s | « Your order number is A-1042. » |
Les tours 2 et 3 ont touché le cache, et le tour 3 a bien retrouvé le numéro de commande donné au tour 1. En Python :
import anthropic

client = anthropic.Anthropic(
    base_url="https://api.aicodewith.ai",
    api_key="VOTRE_API_KEY",
)

SYSTEM = "You are a support agent for Acme. Keep replies short.\n\n" + open("policy.md").read()
history = [{"role": "user", "content": "Hi! My order number is A-1042 and it hasn't shipped yet."}]

def turn(next_user_message=None):
    r = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        cache_control={"type": "ephemeral"},  # automatic caching: moves forward each turn
        system=SYSTEM,
        messages=history,                       # full history, no thread field
    )
    history.append({"role": "assistant", "content": [b.model_dump(exclude_none=True) for b in r.content]})
    if next_user_message:
        history.append({"role": "user", "content": next_user_message})
    u = r.usage
    print(u.input_tokens, u.cache_creation_input_tokens, u.cache_read_input_tokens)
    return r

turn("When will it ship?")
turn("What was my order number again?")
turn()
En TypeScript, même principe, avec l'historique complet dans messages :
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic({
  baseURL: "https://api.aicodewith.ai",
  apiKey: "VOTRE_API_KEY",
});

const history: Anthropic.MessageParam[] = [
  { role: "user", content: "Hi! My order number is A-1042 and it hasn't shipped yet." },
];

const r = await client.messages.create({
  model: "claude-opus-5-5",
  max_tokens: 1024,
  cache_control: { type: "ephemeral" },
  system: "You are a support agent for Acme. Keep replies short.",
  messages: history, // full history every turn, no thread field
});
history.push({ role: "assistant", content: r.content });
console.log(r.usage);
Vérifier si un endpoint prend vraiment en charge les threads
Envoyez une requête continue avec un previous_message_id qui ne peut pas exister. L'API officielle renvoie 404 thread_not_found ; un 200 avec une réponse normale signifie que l'endpoint ignore thread :
# continue from an id that cannot exist
curl -sS https://api.aicodewith.ai/v1/messages \
  -H "x-api-key: VOTRE_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "anthropic-beta: message-threads-2026-08-12" \
  -H "content-type: application/json" \
  -d '{"model":"claude-opus-5-5","max_tokens":200,"cache_control":{"type":"ephemeral"},
       "messages":[{"role":"user","content":"Hi"}],
       "thread":{"type":"continue","previous_message_id":"msg_doesnotexist123"}}'
# official API: 404, error.details.error_code = "thread_not_found"
# a gateway that ignores thread: 200 and a normal reply
Le jour où aicodewith prendra en charge les threads, cette commande le montrera sans toucher au code de votre application.
Erreurs courantes
Selon la documentation officielle, ces erreurs sont renvoyées avant l'exécution du modèle. Elles ne consomment aucun token, et le thread comme son délai d'expiration restent inchangés.
404 thread_not_found
Le thread a expiré (aucune requête depuis 5 minutes), le tour précédent n'a pas été enregistré, la réponse précédente vient d'un modèle de secours, elle est encore en cours de génération, ou la requête utilise une autre clé API, organisation ou espace de travail. Solution : renvoyer la conversation complète dans une nouvelle requête create. Une requête vers un modèle inexistant renvoie aussi une 404 : vérifiez error.details.error_code avant de relancer :
{
  "type": "error",
  "error": {
    "type": "not_found_error",
    "message": "...",
    "details": { "error_code": "thread_not_found" }
  },
  "request_id": "req_..."
}
400 thread_fingerprint_mismatch
Un champ fixe diffère de la requête create : autre model ou thinking, cache_control de premier niveau modifié, un en-tête bêta en plus ou en moins. Le message d'erreur nomme les champs. Pour les changer, démarrez un nouveau thread.
400 thread_already_continued / thread_continue_in_flight
Chaque id de réponse ne peut être continué qu'une fois, ou une requête continue précédente est encore en cours. Continuez toujours depuis le dernier id. En streaming, attendez l'événement message_stop avant de continuer ; continuer plus tôt peut renvoyer une 404.
400 thread_unsupported_request
La requête utilise une fonction que les threads ne gèrent pas : plus de 4 points cache_control (celui de premier niveau compte), la compaction à la demande, la plupart des modes de context editing, ou une organisation avec HIPAA ou Inference hooks activés. Message Batches et le comptage de tokens n'acceptent pas non plus thread. Retirez la fonction ou envoyez la conversation complète sans thread.
Une requête continue contient system ou tools
Renvoie une 400 sans error_code. En continue, n'envoyez que les nouveaux messages ; le thread garde system et tools.
Via aicodewith, le tour de continuation a perdu le contexte
C'est parce qu'aicodewith ignore actuellement thread, sans lever d'erreur. Retirez thread et revenez à l'historique complet + cache_control, comme ci-dessus.
Conservation des données et limites
- Selon la documentation officielle, un thread est gardé en mémoire, chiffré, jamais écrit sur un stockage durable, et supprimé au plus tard 1 heure après sa dernière utilisation. Les threads ne sont pas éligibles à la rétention zéro (ZDR) ni à HIPAA.
- Aucune API ne permet de lister, lire ou supprimer un thread.
- Disponible sur la Claude API, Claude Platform on AWS, Claude Models on Google Cloud (Anthropic managed) et Claude in Microsoft Foundry, en bêta sur tous les modèles.
- Sans lien avec les threads, selon la presse, le filigrane de texte de Claude couvre davantage de modèles à partir du 3 novembre, sans changement de requête nécessaire : voir Filigrane Claude à partir du 3 novembre.
En résumé
Les Message Threads règlent la latence liée au renvoi de tout l'historique à chaque tour : on crée un thread au premier tour, puis on n'envoie que les nouveaux messages et l'id de la réponse précédente. Le premier token arrive plus tôt, la consommation de tokens et la facturation ne changent pas, et il faut toujours garder une copie locale complète pour relancer après les 5 minutes d'expiration. Les agents de longue durée sur l'API officielle ont intérêt à l'activer. Via aicodewith, thread est actuellement ignoré : envoyez l'historique complet avec cache_control ; Claude Code sur aicodewith ne demande aucun changement.
Créer une API Key et démarrer dans Claude Code, Codex ou Cursor →