
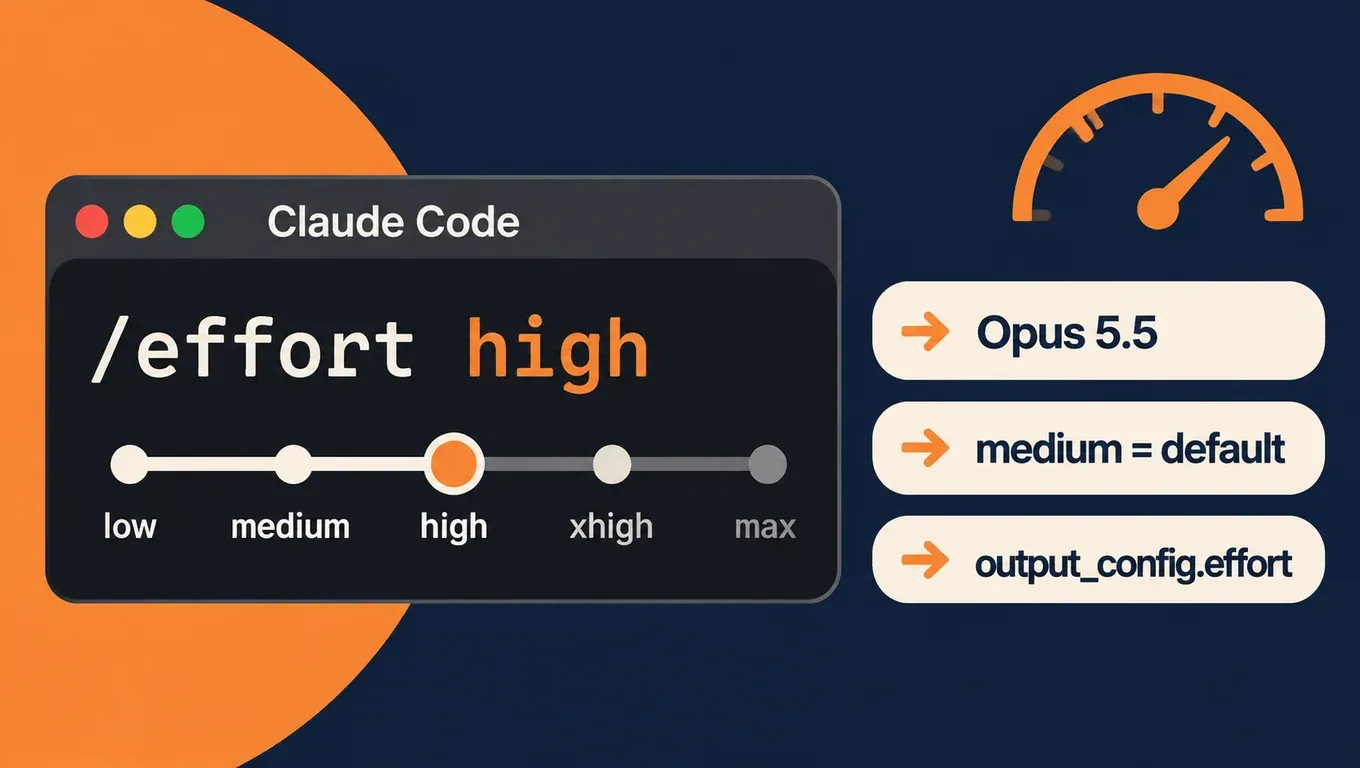
En bref : l'effort détermine combien de temps Opus 5.5 réfléchit et combien il vérifie son propre travail. Il existe cinq niveaux, low, medium, high, xhigh et max, et la valeur par défaut est medium, un cran en dessous du high par défaut d'Opus 5.
- Gardez
mediumpour le travail quotidien bien délimité, comme implémenter une fonctionnalité. Passez àhighpour corriger un bug dans une base de code existante ou pour les tâches riches en cas limites. Réservezxhighetmaxaux longues tâches où le modèle doit vérifier seul. C'est le découpage de la documentation Claude Code. - Selon les retours d'utilisateurs, beaucoup de ceux qui ont fait passer Opus 5.5 de
xhighàhighobtiennent des résultats égaux ou meilleurs. Artificial Analysis a mesuré environ 100M de tokens de sortie enxhighsur sa suite complète, contre 56M enhigh: environ 1,8 fois plus de tokens pour 5 points de plus (57 contre 52). - Un piège dans Claude Code : l'ancienne ligne
"effortLevel": "high"au premier niveau de~/.claude/settings.jsonne s'applique pas à Opus 5.5, qui reste enmedium. Lancez/effort highune fois sous Opus 5.5 : Claude Code l'enregistre par modèle dansmodelSettings. Nous l'avons vérifié nous-mêmes. - Dans l'API, envoyez
"output_config": {"effort": "high"}. Sans ce champ, vous êtes enmedium.
Créer une API Key et utiliser Opus 5.5 dans Claude Code, Codex ou Cursor →
Ce que signifient les cinq niveaux
L'effort n'est pas un plafond strict de tokens. Il indique au modèle combien de travail la tâche mérite, ce qui joue sur la durée de réflexion, la longueur des réponses et le nombre d'appels d'outils. La documentation officielle précise qu'à bas niveau Claude réfléchit encore sur les problèmes assez difficiles, mais moins. Sur Opus 5.5, la réflexion adaptative est toujours active et ne peut pas être coupée : l'effort est donc le réglage principal de la profondeur de raisonnement.
Le tableau rapproche les conseils d'Anthropic des résultats d'Artificial Analysis pour chaque niveau sur l'Intelligence Index v5 (voir les pages low / medium, high et xhigh / max) :
| Niveau | Usage conseillé par Anthropic | Score AA | Tokens de sortie pour la suite complète | Durée moyenne par tâche |
|---|---|---|---|---|
| low | Brainstorming, premières ébauches, petits changements comme un renommage ; sous-agents | 35 | environ 21M | environ 153 s |
| medium (défaut) | Travail quotidien bien délimité, comme une nouvelle fonctionnalité | 48 | environ 43M | environ 347 s |
| high | Travail où la vérification compte ou les cas limites sont probables, comme corriger un bug dans du code existant | 52 | environ 56M | environ 474 s |
| xhigh | Raisonnement plus poussé ; tâches de plus de 30 minutes | 57 | environ 100M | environ 793 s |
| max | Problèmes difficiles que Claude traite seul, comme chercher des failles de sécurité ; risque de trop réfléchir | 58 | environ 218M | environ 1141 s |
Passer de high à xhigh demande environ 1,8 fois plus de tokens pour 5 points. Passer de xhigh à max fait plus que doubler les tokens pour 1 point. AA note aussi que medium, high, xhigh et max sont tous sur sa frontière de Pareto intelligence/dépense : chacun de ces quatre niveaux a ses cas d'usage, aucun n'est simplement le meilleur.
Pourquoi beaucoup baissent l'effort
La discussion a démarré le 31 octobre. Selon Theo (t3.gg), son collègue Julius l'a convaincu une ou deux semaines plus tôt de passer Opus 5.5 de extra high à high, et c'est « mieux presque à chaque fois ». Le lendemain, il a publié un classement des niveaux d'effort avec high en tête, medium et xhigh juste derrière, et max en dernier.
Autres retours typiques :
- Selon @zwb44, qui a mis les chiffres d'AA en graphique, « xhigh : 1,8 fois les tokens pour 5 points de plus » ; après être passé à
highpar défaut, il a nettement senti la différence d'usage et de vitesse. - Selon swyx, ceux qui sont limités en débit peuvent aller plus loin : effort
lowplus une boucle d'autocritique. - Selon @jayleaton, il est en
medium95 % du temps et ne passe enhighque pour l'optimisation difficile de noyaux CUDA. - D'autres pensent au contraire que seuls
highouxhighsuffisent pour coder et quelowest trop faible.
Le résumé X du sujet affirme aussi qu'« Anthropic recommande high comme meilleur équilibre pour la plupart des tâches ». Nous avons parcouru la documentation officielle et n'avons pas trouvé cette phrase pour Opus 5.5. Opus 5.5 démarre en medium ; la phrase sur high comme meilleur équilibre entre qualité et efficacité en tokens figure dans les conseils pour Opus 4.7. Cet article suit la documentation d'Opus 5.5.
Ce que dit Anthropic
- Partir de medium, ne pas reprendre les réglages d'Opus 5 : le guide de prompting d'Opus 5.5 indique que, dans les tests d'Anthropic, Opus 5.5 en
mediumégale ou dépasse Opus 5 enhighsur le code et le travail intellectuel, et que sur plusieurs évaluations de codelows'en approche. À niveau égal, Opus 5.5 réfléchit davantage par tour qu'Opus 5, surtout enxhighetmax: garder l'ancien réglage rallonge les tours et augmente les tokens. - N'utiliser
xhighetmaxque si un gain est mesuré : testez plusieurs niveaux sur vos propres tâches avant de choisir. Pour réduire la réflexion, baissez d'abord l'effort ; c'est plus fiable que des consignes dans le prompt. - La méthode de l'auteur du blog : sur le blog officiel claude.dev, Thariq Shihipar explique dans Spending your effort que pour une nouvelle fonctionnalité il demande à Claude de l'interroger sur la spécification, implémente en
low, relit, puis vérifie et teste enhigh. Dans ses essais, plus l'effort est élevé, plus Claude teste de cas limites et prend de décisions seul ;lowrend plus vite un point de départ, adapté quand vous suivez chaque étape.
Étape 1 : créer une API Key et connecter Claude Code
- Inscrivez-vous sur aicodewith.ai, ouvrez la gestion des clés, créez une Key et copiez la chaîne complète affichée à la création.
- Définissez l'URL et la Key dans le terminal, puis lancez Claude Code sur Opus 5.5 :
export ANTHROPIC_BASE_URL="https://api.aicodewith.ai"
export ANTHROPIC_AUTH_TOKEN="VOTRE_API_KEY"
claude --model claude-opus-5-5
Pour une configuration permanente, Windows ou un conflit de connexion, voir Connecter Claude Code à une API tierce. Codex et Cursor peuvent aussi utiliser les modèles Claude ; le même article les couvre.
Étape 2 : régler et changer l'effort dans Claude Code
La barre du bas de Claude Code affiche le niveau actuel, par exemple ◐ medium · /effort. Les commandes utiles :
/effort status      # Effort level: auto (currently medium)
/effort high        # Set effort level to high (saved as your default for new sessions)
/effort             # interactive slider: low / medium / high / xhigh / max
/effort auto        # clear the saved level for the current model
- Un niveau tapé après
/effort, ou Entrée dans le curseur/effortou le sélecteur/model, est enregistré comme défaut pour ce modèle et survit aux redémarrages. La touchesdans le curseur l'applique à la session en cours seulement. maxn'est jamais enregistré ; il ne vaut que pour la session en cours, sauf via la variable d'environnement.- Le nouveau niveau s'applique à partir de votre prochain message.
Pour changer temporairement sans toucher au défaut enregistré :
# one session only
claude --model claude-opus-5-5 --effort high

# headless run (-p), this run only
claude -p "Fix the failing test" --model claude-opus-5-5 --effort low

# environment variable, overrides everything else
export CLAUDE_CODE_EFFORT_LEVEL=high
Ordre de priorité de Claude Code : la variable CLAUDE_CODE_EFFORT_LEVEL, puis le niveau choisi dans la session avec /effort ou /model, puis l'option --effort au lancement, puis vos réglages, puis le défaut du modèle.
Piège : l'ancienne clé effortLevel est ignorée pour Opus 5.5
Auparavant, /effort écrivait une seule ligne effortLevel au premier niveau de ~/.claude/settings.json. Claude Code enregistre désormais le niveau par modèle. Après /effort high, notre fichier ressemblait à ceci :
{
  "modelSettings": {
    "claude-opus-5-5": {
      "effortLevel": "high"
    }
  }
}
Si vos réglages utilisateur gardent l'ancienne forme :
{
  "effortLevel": "high"
}
Dans notre test, Opus 5.5 lancé avec ce fichier affichait Effort level: auto (currently medium) dans /effort status : l'ancien high était ignoré. Opus 5 lancé avec le même fichier affichait high. C'est conforme à la documentation : un effortLevel de premier niveau dans les réglages utilisateur ne compte pas pour Opus 5.5 et les modèles suivants, alors qu'un effortLevel de premier niveau dans les réglages de projet, locaux ou gérés s'applique à tous les modèles. Après être passé d'Opus 5 à Opus 5.5, lancez /effort status pour savoir à quel niveau vous êtes vraiment.
Vous pouvez aussi définir effort dans le frontmatter d'un skill ou d'un sous-agent pour lui donner son propre niveau. Pour un raisonnement plus poussé sur un seul tour, écrivez ultrathink dans le prompt au lieu de changer le niveau de la session.
Étape 3 : régler l'effort dans une requête API
L'effort se place dans output_config et ne demande aucun en-tête bêta. Avec notre Key, en curl :
curl https://api.aicodewith.ai/v1/messages \
  -H "x-api-key: VOTRE_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-opus-5-5",
    "max_tokens": 32000,
    "output_config": { "effort": "high" },
    "messages": [{ "role": "user", "content": "Write parse_duration(s) ..." }]
  }'
SDK Python :
import anthropic

client = anthropic.Anthropic(base_url="https://api.aicodewith.ai")
resp = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=32000,
    output_config={"effort": "high"},   # low / medium / high / xhigh / max
    messages=[{"role": "user", "content": "Write parse_duration(s) ..."}],
)
text = "".join(b.text for b in resp.content if b.type == "text")  # thinking block comes first
Points d'attention :
- Sans
output_config.effort, c'est le défaut du modèle qui s'applique,mediumsur Opus 5.5. Envoyer"medium"explicitement revient exactement au même. - Plus le niveau est élevé, plus
max_tokensdoit être grand : la réflexion compte dansmax_tokens. Anthropic indique que 128000, le maximum d'Opus 5.5, fonctionne bien pour les longs tours de code agentique. - Le premier bloc de
contentest généralementthinking. Lisez la réponse en cherchant les blocstype == "text"plutôt que de prendre le premier bloc. - Changer l'effort de premier niveau en cours de conversation invalide le cache de prompt. Opus 5.5 accepte un changement d'effort par message (bêta, en-tête
mid-conversation-output-config-2026-07-01) qui conserve le cache ; voir la documentation officielle.
Test : chaque niveau via notre API Key
Test du 1er novembre 2026 avec claude-opus-5-5, tous les appels via notre Key.
API : une même tâche à chaque niveau
La tâche : une fonction parse_duration(s) qui convertit des chaînes comme "1h30m" ou "2d4h" en secondes, en gérant la casse, les espaces, le mauvais ordre, les unités répétées, les décimales, les nombres négatifs et d'autres entrées invalides. Nous avons noté le code de chaque niveau avec 25 cas (10 valides, 15 invalides) :
| effort | Durée | Tokens de sortie | 25 cas |
|---|---|---|---|
| non défini (défaut) | environ 9,8 s | 411 | tous réussis |
| low | environ 9,7 s | 410 | tous réussis |
| medium | environ 10,7 s | 512 | tous réussis |
| high | environ 12,1 s | 473 | tous réussis |
| xhigh | environ 19,8 s | 798 | tous réussis |
| max | environ 258,5 s | 5980 | tous réussis |
Défaut et low donnent presque la même chose parce que la tâche est facile pour Opus 5.5 : même le niveau par défaut réfléchit peu. En max, le modèle a réfléchi plus de quatre minutes et produit plus de dix fois les tokens de high, pour le même 25/25. Notre requête max sans streaming a été coupée après un peu plus de quatre minutes ; en streaming ("stream": true) le résultat est arrivé, donc utilisez le streaming en xhigh et max.
Claude Code : un bug corrigé à quatre niveaux
Une fonction de fusion d'intervalles avait un bug : les intervalles qui se touchent ou sont adjacents n'étaient pas fusionnés, et 2 tests sur 6 échouaient :
# ranges.py
def merge_ranges(ranges):
    """Merge overlapping or touching [start, end] integer ranges."""
    ranges = sorted(ranges)
    out = []
    for s, e in ranges:
        if out and s < out[-1][1]:
            out[-1][1] = max(out[-1][1], e)
        else:
            out.append([s, e])
    return out
Nous avons lancé Claude Code 2.1.310 en low, medium, high et xhigh :
claude -p "Fix merge_ranges in ranges.py so all tests in test_ranges.py pass, then run python3 -m unittest. Reply with one short summary line." \
  --model claude-opus-5-5 --effort high \
  --permission-mode acceptEdits --allowedTools "Bash(python3 -m unittest*)"
| effort | De Entrée au résultat | Résultat |
|---|---|---|
| low | environ 8,8 s | les 6 tests passent |
| medium | environ 10,2 s | les 6 tests passent |
| high | environ 14,2 s | les 6 tests passent |
| xhigh | environ 30,3 s | les 6 tests passent |
Les quatre niveaux ont modifié la même ligne :
-        if out and s < out[-1][1]:
+        if out and s <= out[-1][1] + 1:
Cela rejoint les retours d'utilisateurs : sur une petite tâche bien délimitée avec des tests, monter le niveau rend seulement plus lent, pas meilleur. L'écart entre niveaux apparaît sur les tâches riches en cas limites, sans tests existants, ou quand le modèle doit vérifier seul. C'est là qu'il faut monter.
Créer une API Key et tester vos propres tâches à plusieurs niveaux →
Quel niveau choisir
| Tâche | Point de départ | Remarques |
|---|---|---|
| Questions, renommages, brouillons, sous-agents | low | Rapide ; vous relisez et guidez chaque étape |
| Fonctionnalités bien délimitées, développement courant | medium (défaut) | Selon Anthropic, équivaut à Opus 5 en high |
| Correction de bugs dans du code existant avec tests | high | Selon les retours d'utilisateurs, suffisant pour la plupart de ceux qui ont quitté xhigh |
| Longues tâches, migrations, audits | xhigh | Beaucoup plus de tokens ; max_tokens élevé et streaming |
| Audits de sécurité et problèmes difficiles traités seul | max | Anthropic prévient du risque de trop réfléchir ; essayez d'abord sur un petit périmètre |
Avec un abonnement, un niveau plus élevé consomme plus de tokens et épuise donc votre quota plus vite. Avec une API Key, la consommation de tokens augmente avec le niveau ; vous la voyez requête par requête dans votre historique d'appels.
Erreurs et questions courantes
Erreur « Opus 5.5 effort 必须为 low、medium、high、xhigh 或 max »
Quand nous avons envoyé "ultra" ou "adaptive" comme effort, notre point d'accès a répondu (le message signifie que l'effort doit valoir low, medium, high, xhigh ou max) :
HTTP 400
Opus 5.5 effort 必须为 low、medium、high、xhigh 或 max
Seuls ces cinq noms sont valides. adaptive est un mode de réflexion, pas un niveau d'effort, et le ultracode de Claude Code n'est pas non plus un niveau de l'API : aucun des deux ne va dans output_config.effort.
J'ai réglé high mais Opus 5.5 tourne toujours en medium
Le plus souvent, c'est le problème de l'ancienne clé effortLevel décrit plus haut. Lancez /effort high sous Opus 5.5 et vérifiez avec /effort status. Vérifiez aussi si CLAUDE_CODE_EFFORT_LEVEL est défini : il est prioritaire sur tout le reste.
thinking disabled ou budget_tokens renvoie 400
D'après la documentation sur l'effort et le guide de migration Opus 5.5, la réflexion est toujours active sur Opus 5.5, et thinking: {"type": "disabled"} comme budget_tokens sont rejetés par l'API officielle. Supprimez le champ thinking et pilotez la profondeur avec l'effort. Retirez aussi temperature, top_p et top_k.
La réponse est coupée ou ne contient que de la réflexion
max_tokens est trop petit et la réflexion l'a épuisé. Augmentez max_tokens aux niveaux élevés et utilisez le streaming pour les longues tâches.
Choisir xhigh sur Opus 4.6 ou Sonnet 4.6
Ces deux modèles n'ont pas de xhigh. Claude Code se replie sur le niveau le plus élevé disponible sans dépasser votre choix : xhigh tourne en high sur Opus 4.6.
Le Fast mode, est-ce la même chose que l'effort ?
Non. L'effort décide combien le modèle réfléchit et vérifie ; le Fast mode est un réglage distinct. Pour l'activer et savoir quand il est utile, voir Utiliser le Fast Mode de Claude Opus 5.5.
Opus 5.5 à bas niveau, ou directement Sonnet 5.5 ?
Les deux font gagner du temps et des tokens. Le bon choix dépend de la tâche : testez vos propres tâches sur chacun et comparez. Pour la comparaison des modèles, voir Claude Sonnet 5.5 vs Opus 5.5.
À lire aussi
- Utiliser le Fast Mode de Claude Opus 5.5 dans Claude Code
- Claude Sonnet 5.5 vs Opus 5.5 pour coder
- Quel modèle pour Claude Code : Opus 5.5 ou Sonnet 5.5
- Connecter Claude Code à une API tierce : URL de base, API Key et modèles
- Filigrane de texte Claude au 3 novembre : les sorties de Claude Code et de l'API sont-elles marquées ?
Sources
- Documentation Anthropic : Effort
- Documentation Claude Code : Model configuration (Adjust effort level)
- Anthropic : Prompting Claude Opus 5.5 (Calibrate effort)
- Thariq Shihipar : Using Claude Code: Spending your effort
- Artificial Analysis : Claude Opus 5.5 takes the top spot, et les pages xhigh vs max, high et medium vs low
- Publications de Theo, classement de Theo, swyx, @zwb44 et @jayleaton
- Le résumé du sujet sur X


