
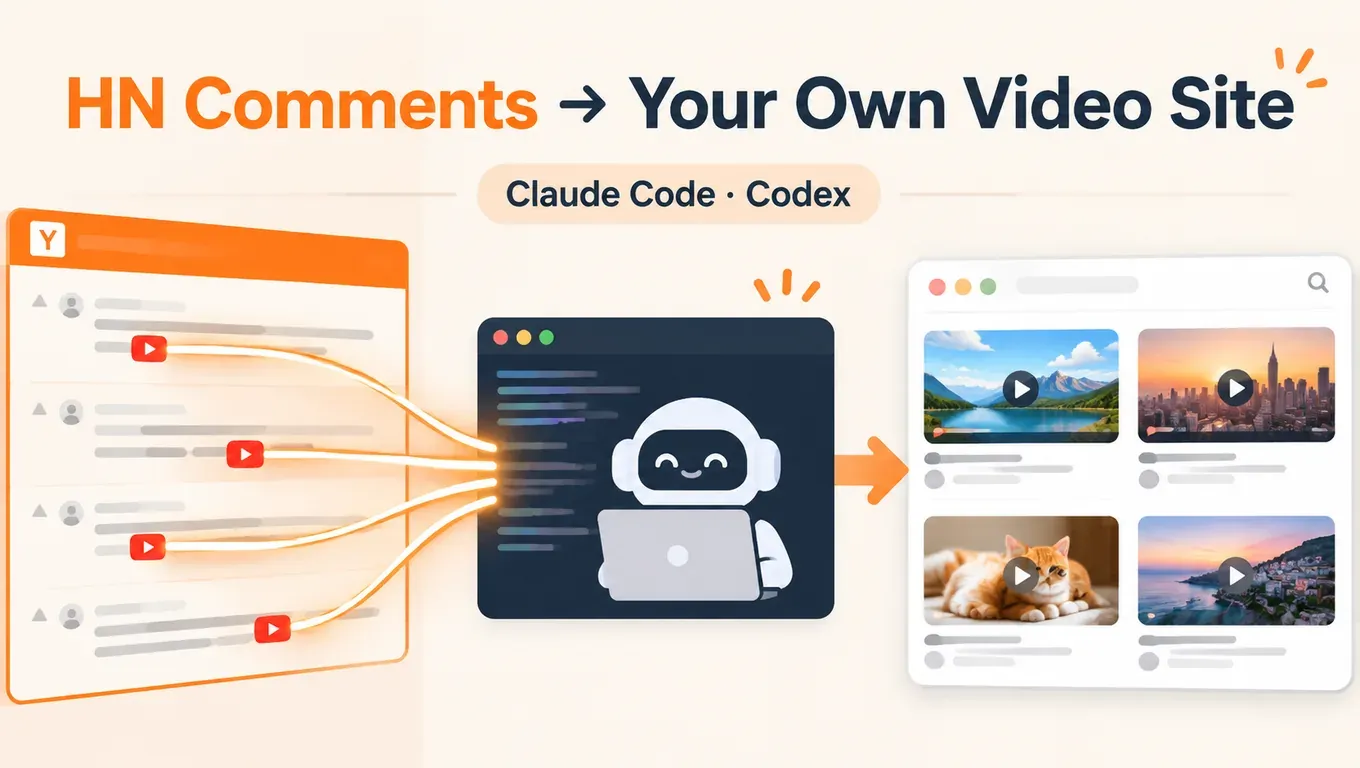
En bref : l'idée de HackerTube est simple. Retrouver chaque lien YouTube posté dans un commentaire Hacker News, ne garder que les vidéos recommandées par beaucoup de personnes différentes sur beaucoup de mois différents, et en faire un site vidéo sans compte ni algorithme de recommandation. Avec Claude Code ou Codex, un seul prompt suffit pour obtenir une version réduite qui fonctionne.
- Selon le post original de Karpathy (1er novembre, UTC), agacé par les recommandations de YouTube, il a demandé à Claude de filtrer environ 43 millions de commentaires publiés sur HN en 20 ans pour garder 6 454 vidéos recommandées encore et encore. Il y a passé environ deux heures, avec l'application de bureau Claude Code et Opus 5.5 en effort Medium. Ses seules actions manuelles : créer une clé Google Cloud pour interroger les métadonnées YouTube, démarrer un VPS et acheter le domaine. L'après-midi du 2 novembre (UTC+8), le post comptait environ 3,3 millions de vues, 39 700 likes et 34 000 signets.
- Avec notre API Key, Claude Code et Codex ont chacun construit une version réduite à partir de l'API Algolia officielle de HN, sur septembre et octobre 2026. Les deux ont terminé en environ 9 minutes, ont trouvé environ 3 600 commentaires avec un lien YouTube et plus de 3 500 vidéos distinctes, ont gardé 193 vidéos partagées par au moins 2 personnes différentes, avec un top 3 identique.
- Ce qui sépare la version réduite de HackerTube, c'est de juger si un commentaire recommande vraiment la vidéo. En classant seulement par nombre de liens, les vidéos d'actualité de la semaine passent devant : les 12 mentions de la vidéo n° 3 viennent toutes du même fil. Le prompt qui ajoute cette étape est donné vers la fin.
Créer une API Key et construire votre propre HackerTube dans Claude Code, Codex ou Cursor →
Ce qu'est HackerTube et comment Karpathy l'a construit
HackerTube se présente comme « les vidéos YouTube que Hacker News n'arrête pas de se conseiller ». Selon sa page About, le site compte 6 454 vidéos, tirées de 39 834 commentaires HN qui les mentionnent, rangées en 150 sujets dans 16 domaines, de 2007 à 2026. Les likes, l'historique et « À regarder plus tard » restent dans votre navigateur, il n'y a pas de compte, et la miniature est une image prise au milieu de la vidéo plutôt que la couverture optimisée par l'auteur.
Selon la section « How it was built » de cette page, le processus tient en cinq étapes :
| Étape | Ce que fait HackerTube |
|---|---|
| 1. Lire tous les commentaires | Parcourir une archive publique complète de HN (le jeu de données open-index/hacker-news) à la recherche de liens YouTube : bien plus de cent mille vidéos |
| 2. Garder les recommandations répétées | Au moins 3 personnes différentes, avec un vrai commentaire, sur au moins 3 mois différents ; il reste environ 7 000 vidéos |
| 3. Faire lire chaque commentaire par un modèle | Claude lit le commentaire avec le titre du fil et décide s'il recommande, cite, plaisante ou critique, puis extrait une citation et des sujets |
| 4. Rédiger une fiche par vidéo | À partir des infos YouTube et de tout ce que HN en a dit : résumé, pourquoi HN l'aime, type, et si elle a bien vieilli |
| 5. Classer | Selon le nombre de mois distincts où elle a été recommandée ; revenir sur plusieurs années compte plus qu'un pic viral |
La page About précise aussi que le site, le pipeline de données, la recherche et les recommandations ont été construits par Claude Opus 5.5 dans Claude Code, et que les étiquettes de commentaires et les fiches vidéo ont été rédigées par des agents Claude Sonnet 5.5 coordonnés par Opus. Les données sont publiées : la page Data propose un zip d'environ 17,8 Mo avec videos.jsonl, mentions.jsonl, la liste des sujets, les embeddings et un DATA.md écrit pour les agents, sous licence ODC-By 1.0. Karpathy suggère dans son post de donner ce fichier à votre Claude pour lui demander votre propre version.
Selon les résumés de tendances de X (un, deux), des variantes sont déjà apparues, comme Hacker Papers pour arXiv ou des listes de livres et de blogs.
Ce que fait la version réduite
Reconstruire 20 ans de données implique de télécharger toute l'archive HN, ce qui est trop pour un premier essai. Nous avons limité la période à deux mois et utilisé uniquement l'API de recherche Algolia officielle de HN, qui ne demande aucune clé :
| Étape | Méthode | Résultat |
|---|---|---|
| 1. Récupérer les commentaires | Algolia search_by_date, tags=comment, découpé en fenêtres de temps | data/comments.jsonl |
| 2. Extraire les liens | Repérer les identifiants vidéo de 11 caractères, en couvrant watch?v=, youtu.be/, /shorts/ et les autres formes | Vidéos citées par commentaire |
| 3. Dédoublonner et compter | Mentions, personnes distinctes et mois distincts par vidéo | Classement |
| 4. Ajouter les titres | oEmbed de YouTube, sans clé | data/videos.json |
| 5. Générer la page | Un fichier HTML statique avec une grille de cartes et un champ de recherche côté client | site/index.html |
Étape 1 : créer une API Key et connecter Claude Code ou Codex
- Inscrivez-vous sur aicodewith.ai, connectez-vous, ouvrez la gestion des clés, créez une clé et copiez la chaîne complète.
- Claude Code : définissez l'adresse et la clé, créez un dossier vide et lancez-le dedans :
export ANTHROPIC_BASE_URL="https://api.aicodewith.ai"
export ANTHROPIC_AUTH_TOKEN="VOTRE_API_KEY"
mkdir -p ~/hackertube-mini && cd ~/hackertube-mini
claude --model claude-opus-5-5
Pour enregistrer ces réglages durablement ou les définir sous Windows, voir Connecter Claude Code à une API tierce. Karpathy utilisait Opus 5.5 en effort Medium ; pour choisir le niveau, voir Niveaux d'effort de Claude Opus 5.5, et pour comparer les modèles, Quel modèle utiliser dans Claude Code.
- Codex : ajoutez ceci dans
~/.codex/config.toml, avec la clé écrite directement dansexperimental_bearer_token:
# ~/.codex/config.toml
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
model_provider = "aicodewith"

[model_providers.aicodewith]
name = "aicodewith"
base_url = "https://api.aicodewith.ai/chatgpt/v1"
wire_api = "responses"
experimental_bearer_token = "VOTRE_API_KEY"
Chaque champ est expliqué dans Le fichier config.toml de Codex. Si vous débutez avec Codex, commencez par Comment utiliser Codex et Installer Codex.
Étape 2 : regarder d'abord l'API Algolia de HN
Lancez une requête avant de commencer pour voir à quoi ressemblent les données. Celle-ci demande les commentaires publiés le 2026-09-01 qui contiennent youtu (cela couvre youtube.com et youtu.be) :
# comments posted on 2026-09-01 (UTC) that contain "youtu"
curl "https://hn.algolia.com/api/v1/search_by_date?query=youtu&tags=comment&hitsPerPage=1000&numericFilters=created_at_i>=1788220800,created_at_i<1788307200"
Dans notre test, HN comptait 10 830 commentaires ce jour-là, dont 197 contenaient youtu. Deux limites comptent :
- Chaque requête renvoie au plus 1000 résultats. Sur deux mois,
youtube.comà lui seul correspond à plus de 4 000 commentaires et le reste est coupé : il faut découper la période en petites fenêtres. - Chercher
youtuberate les liens courts.youtu.be/xxxxne contient pas le motyoutube. Cherchez le préfixeyoutu, puis filtrez précisément en local avec une expression régulière.
Nous avons mis ces deux points dans le prompt, et Claude Code comme Codex ont tout de même testé les requêtes et vérifié la limite avant d'écrire le pipeline.
Étape 3 : donner le prompt à l'agent
Enregistrez le texte ci-dessous dans prompt.txt et donnez-le à Claude Code ou à Codex. C'est exactement celui de notre test :
Build a mini "HackerTube" in this folder: a static site of the YouTube videos that Hacker News commenters keep recommending to each other.
1. Fetch data only from the official HN Algolia API (https://hn.algolia.com/api/v1/search_by_date, tags=comment). Take every comment created from 2026-09-01 00:00 UTC to 2026-10-31 23:59 UTC that contains a YouTube link (youtube.com/watch, youtu.be/, /embed/, /shorts/, m.youtube.com, music.youtube.com). Note the API returns at most 1000 hits per query, so split the time range into small enough windows. Be polite: at most 2 requests per second. Save raw hits to data/comments.jsonl.
2. Extract and normalize the 11-character video ids (HTML-unescape the comment text first), and drop the commenter's own repeated links within the same comment.
3. For each video count: mentions, distinct commenters, distinct months, first and last mention, and keep up to 3 short quotes with links to the HN comment (https://news.ycombinator.com/item?id=...). Keep a video only if at least 2 different people linked it. Rank by distinct commenters, then mentions.
4. Get titles for the kept videos from YouTube oEmbed (https://www.youtube.com/oembed?url=...&format=json, no API key); if oEmbed fails keep the id and mark it unavailable. Save data/videos.json.
5. Generate site/index.html: a single static page, no login and no tracking, with a grid of cards (thumbnail from https://i.ytimg.com/vi/<id>/hqdefault.jpg, title, channel, "N people / M mentions", one quote) and a client-side text filter.
6. Write the whole pipeline as a reusable script build.py (stdlib only, with a --since/--until option) and run it. Finally reply with: total comments fetched, unique videos found, videos kept, the top 10 videos (id, title, people, mentions), and any problems you hit.
Trois points comptent dans ce prompt : désigner l'API officielle comme seule source évite que l'agent aille aspirer des pages web ; annoncer d'emblée la limite de 1000 résultats et le rythme des requêtes lui évite de découvrir des trous à mi-chemin ; demander un build.py relançable permet de changer de période ou de seuil sans nouvelle conversation.
Pour l'exécuter en arrière-plan, utilisez le mode non interactif. Avec Claude Code, --allowedTools n'autorise que les commandes nécessaires. Le bac à sable par défaut de Codex n'a pas d'accès réseau : nous avons donc utilisé --sandbox danger-full-access dans un dossier vide dédié. Cette permission est large, ne l'utilisez pas dans un dossier contenant des fichiers importants ; les options sont détaillées dans Permissions d'automatisation de Codex :
# Claude Code, non-interactive: only allow the commands this job needs
cat prompt.txt | claude -p --model claude-opus-5-5 \
  --permission-mode acceptEdits \
  --allowedTools "Bash(python3:*)" "Bash(curl:*)" "Bash(ls:*)" "Bash(mkdir:*)" "Bash(head:*)" "Bash(wc:*)"

# Codex, non-interactive (reads the prompt from stdin)
codex exec --skip-git-repo-check --sandbox danger-full-access - < prompt.txt
Test : Claude Code et Codex avec notre API Key
Les deux clients ont reçu le même prompt et ont tourné en même temps sur la même machine Linux, l'après-midi du 2 novembre 2026 :
| Claude Code 2.1.316 + Opus 5.5 | Codex 0.166.0 + GPT-6.1 Sol | |
|---|---|---|
| Durée | Environ 555 secondes, 21 tours | Environ 534 secondes, 30 commandes exécutées |
| Récupération | Fenêtres d'un jour sur youtu, toute fenêtre au-delà de 1000 résultats coupée en deux ; 61 requêtes | 61 fenêtres d'un jour sur youtu, en vérifiant qu'aucune n'atteint 1000 |
| Commentaires avec lien YouTube | 3 624 | 3 619 |
| Vidéos distinctes | 3 511 | 3 505 |
| Gardées (au moins 2 personnes) | 193 | 193 |
| Sans titre | 2 (oEmbed a renvoyé 403 et 401) | Idem |
| Vérifications | Comparaison avec un parcours complet d'une journée : les deux trouvent les mêmes 87 commentaires avec lien | 5 tests écrits, page ouverte dans Chrome headless pour contrôler les cartes et la recherche |
| Résultat | build.py de 418 lignes, index.html d'environ 258 Ko | build.py de 258 lignes, index.html d'environ 210 Ko |
Les deux clients ont choisi d'eux-mêmes la même approche : au lieu de parcourir tous les commentaires (environ 600 000 en deux mois), ils ont cherché youtu jour par jour, puis filtré précisément en local. Claude Code a aussi vérifié ce raccourci : un parcours complet du 1er septembre a donné exactement le même résultat, et il a noté que chercher youtube aurait raté 20 commentaires avec des liens courts.
Le top 10 était presque identique des deux côtés, et le top 3 strictement identique. Nous avons aussi compté combien de mentions de chaque vidéo venaient d'un même fil :
| Rang | Vidéo | Personnes | Mentions | Mois | Max dans un seul fil |
|---|---|---|---|---|---|
| 1 | 216,000,000 Spy TVs – The LG Smart TV Problem | 15 | 18 | 2 | 7 |
| 2 | Kernel Recipes 2026 - Security in the LLM age | 12 | 21 | 1 | 2 |
| 3 | The FLYING Tesla Roadster explained by the man who engineered it | 11 | 12 | 1 | 12 |
| 4 | LG Says We're Fake News | 6 | 7 | 1 | 6 |
| 5 | Reinventing Entropy – Compression is Intelligence Part 1 | 6 | 6 | 2 | 3 |
Chaque vidéo de data/videos.json ressemble à ceci, avec des citations qui renvoient au commentaire HN d'origine :
{
  "id": "6IFVTcM28KA",
  "title": "216,000,000 Spy TVs | The LG Smart TV Problem",
  "people": 15, "mentions": 18, "months": 2,
  "first_mention": "2026-09-07T10:52:26Z",
  "last_mention": "2026-10-13T16:41:11Z",
  "quotes": [
    {"author": "wavesplash", "date": "2026-09-07",
     "url": "https://news.ycombinator.com/item?id=49597752",
     "text": "... Worth a watch to see how bad this is"}
  ]
}
Le build.py généré peut être relancé avec une autre période ou un autre seuil (version de Claude Code) :
python3 build.py --since 2026-09-01 --until 2026-10-31   # full run
python3 build.py --skip-fetch --min-people 3              # rebuild from saved comments with a stricter rule
python3 build.py --full-scan                              # scan every comment instead of the "youtu" prefilter (slow)
Trois problèmes révélés par le test
- Classer par nombre de liens confond l'actualité de la semaine avec un classique. Les 12 mentions de la vidéo n° 3 viennent toutes d'un fil consacré à cette vidéo, et 6 mentions de la n° 4 aussi. C'est précisément pour cela que HackerTube exige au moins 3 mois différents et fait juger chaque commentaire par un modèle. Sur nos deux mois, seules 22 vidéos réunissent au moins 3 personnes et au moins 2 mois.
- Les gens collent souvent des URL mal formées, et les deux clients ne les traitent pas pareil. Claude Code a gardé 5 commentaires de plus que Codex, tous avec des URL comme celles-ci. Claude Code prend les 11 premiers caractères et les garde ; Codex les analyse comme des URL standard et les écarte. La troisième a en réalité deux caractères de trop, donc couper à 11 peut désigner la mauvaise vidéo :
https://www.youtube.com/watch?v=sCr_gb8rdEI?t=11m     <- "?" instead of "&"
https://youtu.be/69o-8Mtd3Kc&t=330                    <- "&" instead of "?"
https://www.youtube.com/watch?v=909o_kbCdFgll         <- 13 characters, not 11
- oEmbed ne renvoie pas un titre pour chaque vidéo. 2 des 193 vidéos gardées ont renvoyé 403 ou 401, probablement privées ou avec l'intégration désactivée ; les deux clients les ont marquées indisponibles avec seulement l'identifiant. Pour la durée, les vues et ce genre d'informations, il faut une clé YouTube Data API créée dans Google Cloud, comme l'a fait Karpathy.
De la version réduite à HackerTube
D'abord, faire juger chaque commentaire par un modèle. C'est ce qui change le plus le résultat. Dans le dossier de la version réduite, dites à l'agent :
For each comment in data/comments.jsonl, read the comment text and the HN story title,
and label what the commenter does with the video: strong_rec, rec, reference, joke or critical.
Write the labels to data/stance.jsonl. Then only count strong_rec and rec,
keep a video if at least 3 different people recommended it in at least 3 different months,
and rank by the number of distinct months. Rebuild site/index.html.
Juger des milliers de commentaires un par un prend du temps : laissez l'agent les répartir en lots parallèles. Lancer trop de tâches Codex en même temps peut provoquer des erreurs 429 ; pour régler la concurrence, voir Résoudre l'erreur Codex 429 Too Many Requests.
Ensuite, utiliser plus de données. Algolia convient pour récupérer par période ; pour couvrir de 2007 à aujourd'hui, l'archive open-index/hacker-news citée sur la page About de HackerTube est plus adaptée. Le plus simple est de télécharger le zip de HackerTube, de faire lire DATA.md à l'agent, puis d'adapter l'interface ou le classement à votre goût.
Enfin, mettre en ligne. La version réduite est une page statique qui s'ouvre sur n'importe quel hébergement statique. Selon le post de Karpathy, il a donné l'IP du VPS à Claude en lui demandant de mettre à jour, sécuriser, renforcer, déployer et optimiser, et Claude a tout fait.
Questions fréquentes
Algolia renvoie moins de résultats que nbHits
Chaque requête renvoie au plus 1000 résultats ; nbHits n'est que le total. Réduisez les fenêtres de temps jusqu'à ce que chacune ait moins de 1000 résultats. Des fenêtres d'un jour nous ont suffi, et les jours chargés peuvent être recoupés en deux.
Pourquoi chercher youtube ne trouve pas tout
Les liens courts youtu.be ne contiennent pas youtube. Cherchez youtu, puis filtrez en local avec une expression régulière pour watch?v=, youtu.be/, /embed/, /shorts/ et les formes voisines.
Les liens des commentaires ressemblent à /
Algolia renvoie comment_text échappé en HTML : / devient / et & devient &. Décodez le HTML avant d'extraire les liens, sinon l'expression régulière ne trouvera rien. Le point 2 de notre prompt le précise.
Faire pareil pour des articles, des livres ou des podcasts
Remplacez YouTube dans le prompt par arxiv.org/abs/, amazon.com/dp/ ou des liens de podcasts ; le comptage et la page restent identiques. Pour lire les articles ensuite, voir Chercher et lire des articles arXiv avec Claude Code.
Faire suivre les mêmes règles à l'agent à chaque fois
Écrivez la source de données, les seuils et les exigences de la page dans le CLAUDE.md ou l'AGENTS.md du projet ; voir Rédiger le CLAUDE.md de Claude Code.
En résumé
HackerTube montre que les petits produits qui « filtrent le contenu selon le goût des autres » sont désormais à la portée d'une seule personne avec un agent de code. Dans notre test, récupérer les commentaires Hacker News avec Claude Code ou Codex, en extraire les liens YouTube et produire un site vidéo statique utilisable a pris environ 9 minutes. Ce qui fait vraiment la qualité, c'est la règle qui définit une recommandation, et une période assez longue.
Créer une API Key et commencer dans Claude Code, Codex ou Cursor →


